أسكي
المحتويات
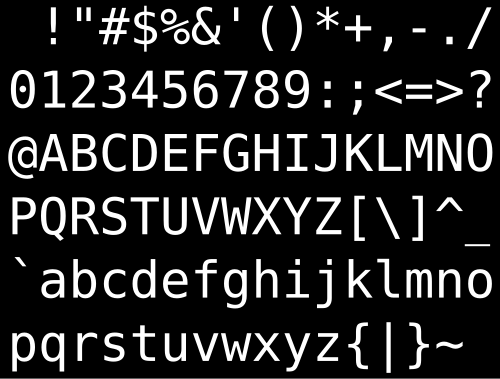
تعريفًا بالموضوع، آسكي هي مجموعة رموز ونظام ترميز مبني على الأبجدية اللاتينية بالشكل الذي تستعمل به في الإنجليزية الحديثة ولغات غرب أوروبية أخرى. من أكثر الاستخدامات شيوعًا للنصوص المكتوبة بالآسكي، استخدامها في أنظمة الحاسوب، وفي أجهزة الاتصالات وأنظمة التحكم التي تتعامل مع نصوص. ونتناول فيما يلي مزيدًا من التفاصيل.
في هذا الإطار، يعرّف نظام آسكي القياسي الرموز القابلة للطباعة الآتية، مرتبة حسب قيمة آسكي الخاصة بها.
قائمة الرموز
@ABCDEFGHIJKLMNOPQRSTUVWXYZ[\]^_
في هذا الإطار، أما الرموز الأخرى فهي الرموز الطباعية، وتشمل الفراغ (الرمز 32) والأرقام العربية الغربية، والحروف اللاتينية الكبيرة والصغيرة دون شكلات، ومجموعة من علامات التنقيط والحساب المختارة. يذكر أن عددا من علامات التنقيط هذه تستعمل لأغراض برمجية شتى.!"#$%&'*+,-./0123456789:;<=>?
كذلك، بعض هذه الرموز لا يمكن إظهارها، وهي الرموز عدد 0 إلى 31 وكذلك الرمز 127. تستعمل هذه الرموز أوامر تحكم لطرفيات الحاسوب، فمثلًا يعد الرمز 127 أمر الحذف، بينما الرمز 7 أمر إشارة صوتية.
صفحة الترميز Code Page IBM 367
تغيرات نظام آسكي وأنظمة أخرى مستمدة منه
وفي هذا السياق، US-ASCII ، وهي تسمية عامة يمكن أن تحيل على أي من الأشكال السابقة لهذا المعيار.
من جهة ثانية، مازال استعمال آسكي دارجًا إلى اليوم في الحواسيب على نطاق واسع، وبعض خدمات البريد الإلكتروني (MIME) ورسائل الهاتف SMS مازالت تستعمل النسخة الأصلية بطول 7 بتات للحرف بدل 8. كما أن أكثر المعايير البديلة الرائجة في الوقت الحالي تحافظ على التوافق مع قيم رموزه.
التاريخ
أصناف الحروف
وفي هذا الصدد، رجوعًا إلى أوائل الستينيات، لم يكن هناك ما يعرف بنظام الآسكي أو بأسلوب موحد. من هذا المنطلق كانت الشركات المصنعة لأجهزة الحاسب وآلات رقن الأوراق المثقوبة، تؤدي مهامها بأي طريقة كانت ترى بأنها مناسبة لتأدية الغرض. أدى ذلك إلى وضعية من الفوضى حيث لم يكن هناك وسيلة لاتصال أجهزة الكمبيوتر المختلفة مع بعضها البعض. فقد كان لكل شركة مصنعة طرقها الخاصة المستعملة في تمثيل الحروف الأبجدية والأرقام وأمثالها (تقدر بالستين في نفس الفترة)، وأحيانا في نفس الشركة تختلف هذه الطرق: مثلًا كان لشركة آي بي إم مع اختلاف معداتها تسع مجموعات أحرف مختلفة.
إضافةً إلى ذلك، رعى المعهد الوطني الأمريكي للمقاييس (ANSI)، وقد كان وقتها معروفا بجمعية المعايير الأمريكية (American Standards Association أو ASA) تأسيس لجنة أسموها X3 عكفت على تحديد «شيفرة المعيار الأمريكي لتبادل المعلومات» (American Standard Code for Information Interchange) وإختصارها ASCII. ظهرت أول مراجعات هذا المعيار في سنة 1963 ومرت على تنقيحات كثيرة آخرها كان في سنة 1986.
وفي هذا السياق، قام بوب بيمير الذي كان يعمل لصالح شركة آي بي إم (شركة أعمال دولية) بالإضطلاع بدور هام في تأسيس نظام الآسكي ابتداء من عام 1960، وقد لقب تبعا لذلك «والد الآسكي».
`abcdefghijklmnopqrstuvwxyz{|}~
ومن ناحية أخرى، على مر الزمن ومع التقدم التقني، ظلت التسميات المستعملة نفسها لكن المعنى اختلف لأنه يرتبط بتقنيات لم تعد مستعملة:
كذلك، رمز الحذف (DEL): كان معناه الأصلي في آلات الرقن التي تتعامل مع البطاقات المثقوبة، مثل تيليتايب. حيث أنه في حال إرتكاب المستعمل لخطأ، كان هناك زر يرجع رأس الكتابة إلى الحرف السابق ويثقب جميع الثقوب (أي ما يعادل 1111111 أو 127، وهو رمز DEL)، ومن يستقبل الرسالة عليه أن يتجاهل وجود ذلك الرمز «المحذوف». لكنه بالتدريج صار يستعمل في نفس سياقات استعمال BS لحذف الرمز السابق.
في الجدول أدناه توضيح لقيم رموز ترميز آسكي.
وفي هذا السياق، نهاية الملف، كان يشار لها برمز المعوض (SUB) للإشارة لمكان إنتهاء الملف (و يسمى في لغات البرمجة EOF)، لكن بعض الإصطلاحات البرمجية تستعمل رمز العدم (NUL) بديلًا عن ذلك.
وفي هذا السياق، رمز العودة للخلف (BS): رمز مرتبط بزر Backspace على لوحات المفاتيح الحديثة. وقع خلط بينه وبين رمز DEL أيهما معني بحذف الرمز السابق، إذ أن توزيعهما على الأزرار وطريقة عملهما إختلفت حسب نوع الجهاز.
من جهة ثانية، عودة السطر (CR) و تخطي السطر الجديد (LF): كانت في الأصل مرتبطة بآلات الرقن، والتي تشترط في بداية سطر جديد كلتي التعليمتين، الأولى لتحريك رأس الكتابة إلى مكان أول السطر، والثانية لتحريك الورقة. ورثت أنظمة تشغيل الحاسب عرف استعمال التعليمتين تلو بعض، لكن بعض البرامج تستعمل تخطي السطر الجديد (LF) وحده، وأحدث هذا فروقا ومشاكل توافق بين المعايير.
وعلى صعيد آخر، رمز الهروب (ESC): كان القصد الأصلي منه السماح بإرسال القيم الرقمية لرموز التحكم، عوضا عن تنفيذ معناها مباشرة على الحاسب. في الإستعمالات الحديثة، صار يعني إيقاف عمل العملية الحالية أو الخروج التام من التطبيق.
الحروف القابلة للطبع
من جهة ثانية، الرموز التي تسير من 20hex إلى 7Ehex (أي الحرف ما قبل الأخير في صيغة الآسكي المعتمدة على سبعة بتات والذي يقابله العدد 126) هي حروف قابلة للطبع. الحرف الأخير (أي الحرف الذي يقابله العدد 127) هو حرف غير قابل للطبع.
حدود استعمالات ترميز الآسكي
كذلك، ظهرت على ثلاث فترات، مقاربات بديلة مختلفة لتوطين ترميز النصوص جراء حدود المعيار الأمريكي آسكي:
من جانب آخر، ظهور معايير امتدادية، يكون للنص فيه سياق، وباختلاف السياقات تكون لنفس القيمة رموز مختلفة (مثل أسرة معايير ISO/CEI 2022). مثلًا نذكر فكرة «صفحات الترميز» (code page) على غرار ويندوز 1252 للغة العربية. من مساوئ هذه الطريقة أنها تسبب تضاربًا في تأويل النص بين المعايير المختلفة.
وفي هذا الصدد، يخلو نظام ترميز آسكي من الرموز الكافية لإمكانية تمثيل النصوص بلغات غير اللغة الإنكليزية، كما أن كمية الرموز الخاصة التي يحتويها محدودة، مما أدى لضرورة استعمال أنظمة ترميز نصوص مختلفة لغيرها من اللغات على غرار العربية أو الروسية أو لغات أوروبا الشرقية وغيرها الكثير.
في هذا الإطار، ANSI X3.4:1986 (و أحيانا يسمى، خطأَ، «معيار ANSI» مع أن اللفظة تعني في الأصل «المعهد الوطني الأمريكي للمقاييس» وهذا المعيار كان قراراً منه)
ومن جهة أخرى، ظهور معايير شاملة لعدة لغات وتستعمل عدة بايتات، وكان معيار يونيكود الكفيل بهذا لكونه يغطي العدد الأكبر من اللغات.
وفي السياق ذاته، ظهور معايير محلية، طول الرمز فيها بايت واحد، وهي أسهلها إنشاء. مثلًا يذكر معيار ASMO 449 للغة العربية الذي هو معيار ASCII بتعويض الحروف اللاتينية بمقابلات عربية. من مساوئ هذه الطريقة أن كم الرموز الذي يمكن التعبير عنه محدود بهذا المعيار، ويجب توضيح الترميز لزومًا خارج النص.
ISO/CEI 646-US
وفي هذا السياق، في خضم هذه المراحل، تمت إعادة تصنيف وتسمية معيار آسكي الأصلي قبل كل تلك البدائل الجديدة إلى الأسماء التالية:
تعريف معيار آسكي
من جانب آخر، إختلفت طرق التعامل مع البت الثامن، فبينما فضلت جل الحواسيب إسناد صفر له (و هو الحل الشائع)، قامت بعض الأنظمة (مثل Prime Computer التي شغلت نظام تشغيل PRIMEROS) بإسناد واحد له، وفي أنظمة أخرى تم استعماله بت تكافؤ للتأكد من خلو الاتصالات من الأخطاء، أو لأغراض تختلف حسب الهدف من الجهاز المستعمل. ولاحقًا، ظهرت استعمالات في معايير ترميز امتدادية، للتعبير عن المزيد من الرموز والحروف التي يعجز آسكي عن التعبير عنها.
ومن جهة أخرى، يُعَرِّفُ معيار آسكي مجموعة 128 رمزا أسندت لها أعداد ترتيبية من 0 إلى 127 وتم ترميزها بالنظام الثنائي من 0000000 إلى 1111111، وبالتالي تكفي 7 بتات للتعبير عنها. لذا يعد معيار ترميز 7 بتات. لكن بما أن الحواسيب تتعامل مع البايت (أي 8 بتات) فيقع التعبير عن رموز آسكي ببايت كامل يكون فيه البت الثامن غير مستعمل.
وفي السياق ذاته، يكتفي معيار آسكي بترجمة تسلسل من البتات إلى حرف أو رمز معين. بالتالي، لن يعبر عن شكل ظهور النصوص أو ترتيبها، وتلك الأمور تقع على عاتق وسائل أخرى مثل اللغات الترميزية (أي لغات توصيف النص) على غرار إتش تي إم إل وغيرها.
من جانب آخر، يعتبر معيار آسكي من بين أنظمة تمثيل الرموز في الحاسوب، ويحدد علاقة تناظر بين قيمة رقمية لتتابع البتات وبين رمز أو رسم مستعمل في اللغة المكتوبة. إذ أن الحواسيب تتعامل فقط بإشارات كهربائية إما صفر أو واحد، أي البت (bit) في لغة البرمجة، ويمكن أن تمثل هذه البتات بتسلسلها أرقاما بالنظام الثنائي، ومجموعة من ثمانية بتات تمثل البايت (بالإنكليزية: Byte، بالفرنسية: Octet). ومن ثمة ظهرت الحاجة للتعبير عن الحروف والرموز بواسطة الأرقام الثنائية.
حروف التحكم
ومن ناحية أخرى، يخصص الآسكي الحروف الاثنين والثلاثين الأولى من أجل حروف التحكم.
يونيكود
ومن جهة أخرى، قد يمثل يونيكود الحروف في ثماني بتات أو ستة عشر بتا أو اثنين وثلاثين بتا. هذه الأنظمة الثلاثة تسمى على التوالي UTF-8 وUTF-16 وUTF-32.
فن أسكي
أنظر كذلك
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟