اللغة اليابانية والحواسيب
المحتويات
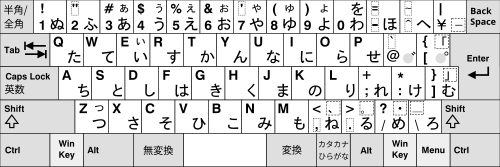
على سبيل التعريف، تنشأ الكثير من المشكلات عند محاولة تكييف اللغة اليابانية مع الحواسيب، بعض هذه المشكلات تختص بطبيعة اللغة اليابانية نفسها أما البعض الآخر فتعتبر مشكلات عامة تواجه أغلب اللغات التي تحوي عددا كبيرا من الرموز. عدد الرموز المطلوبة للكتابة باللغة الإنجليزية قليل، بالتالي فمن الممكن استخدام بايت واحد فقط (28=256 قيمة ممكنة) لتشفير كل حرف باللغة الإنجليزية. من ناحية أخرى، فإن عدد الرموز في اللغة اليابانية أكثر بكثير من 256 بالتالي لا يمكن تشفير كل هذه الرموز في بايت واحد فقط، فلذلك يتم تشفير اليابانية باستخدام 2 بايت أو أكثر فيما يسمى «البايت المزدوج» (بالإنجليزية: Double Byte أو Multi-byte). تتعلق هذه المشكلات عادة بالنقل الحرفي «النقحرة» والرومنة وتشفير الرموز وإدخال النصوص اليابانية. وفيما يلي تفاصيل أوسع عن ذلك.
إدخال النص
وفي السياق ذاته، تستعمل اللغة اليابانية المكتوبة عدة طرق كتابة مختلفة، جميعها مستعملة وهي: الكانجي (الرموز الصينية) ومجموعتان من الكانا (الرموز الصوتية) وأحرف رومانية. في حين يمكن طباعة الكانا والحروف الرومانية مباشرة في الحاسوب، فإن إدخال الكانجي عملية معقدة أكثر نظرا لوجود رموز كانجي أكثر بكثير من عدد المفاتيح الموجودة في أغلب لوحات المفاتيح. لإدخال رمز كانجي على جهاز حاسوب، أولا يتم إدخال القراءة الصوتية لرمز الكانجي، بعدها يُظهِر ما يسمى بـ«محرر أسلوب الإدخال» (بالإنجليزية: Input method editor أو IME) قائمة لرموز الكانجي المطابقة للقراءة الصوتية، ثم يختار المستعمل الكانجي الذي يوّد إدخاله. تعمل «محررات أسلوب الإدخال» الأكثر تطورا من خلال الجمل لا من خلال القراءة الصوتية فقط، مما يزيد من احتمالية ظهور الكانجي المُراد إدخاله كخيار أول أو خيار متقدم في قائمة الإدخال. يمكن استخدام الحروف الرومانية في كتابة القراءة الصوتية أو استخدام الكانا مباشرة. استخدام نظام ادخال الحروف الرومانية كقراءة صوتية يُعتبر أكثر شيوعا على أجهزة الحاسوب أو الأجهزة التي تستعمل لوحات مفاتيح كاملة الحجم (مع ذلك فإن استخدام مدخلات الكانا مباشرة مدعومة كذلك على نطاق واسع)، ويتم استخدام الكانا عادة على الهواتف المحمولة والأجهزة المشابهة.
في هذا الإطار، هناك نظامان رئيسيان لكتابة اليابانية بحروف رومانية، هما Kunrei-shiki وهيبورن. لكن عملياً، تسمح لوحة المفاتيح روماجي (المعروفة كذلك باسم wāpuro romaji) بمزيج من الاثنين. كما تتعامل محررات أسلوب الإدخال "IME" مع الرموز الرومانية غير المستعملة في اليابانية، مثلًا فهي تحوّل حرف L الروماني إلى أنسب وأقرب مكافئ لها في اليابانية. أما بالنسبة للكانا، فإن كل مفتاح على لوحة المفاتيح يتطابق مباشرة مع رمز كانا واحد. نظام لوحة المفاتيح JIS يُعتبر المعيار الوطني، ولكن هناك بدائل، مثل لوحة مفاتيح thumb-shift التي يستعملها الكاتبون المحترفون.
تشفير الرموز
إضافةً إلى ذلك، يوجد عدة طرق نموذجية مستعملة في تشفير الرموز اليابانية واستخدامها في الحواسيب، منها JIS وShift-JIS و EUC والترميز الموحد. وبينما يعتبر تحديد خريطة رموز الكانا للتشفير أمرا بسيطا، فإن القيام بالأمر نفسه لرموز الكانجي يعتبر أكثر صعوبة وتعقيدا. على الرغم من الجهود المبذولة في الوصول إلى نظام تشفير نموذجي لرموز الكانجي، إلا أن الكثير من طرق التشفير بقيت قيد الاستخدام حتى الألفيات، ولم يتم الوصول إلى نموذج تشفير معياريّ وفعال وعالمي بعد. بحلول عام 2017، وصلت نسبة حركة نظام UTF-8 على الإنترنت إلى 90% عالميا، بينما كانت نسبة استخدام Shift-JIS وEUC معا 1,2% فقط. مع ذلك، فما زالت الكثير من مواقع الإنترنت المشهورة تستعمل Shift-JIS مثل 2channel.
وفي السياق ذاته، بعض أنظمة تشفير الرموز مثل JIS، لا تتضمن جميع الرموز المطلوبة، لذلك يتم استخدام ما يسمى بـ«غايجي» (بالإنجليزية: gaiji أو الرموز الخارجية "外字") كملحق لمجموعة الرموز في النظام. تُستعمل الغايجي كحزم خارجية، تُستبدل داخلها الرموز العادية برموز جديدة أو يتم فيها إضافة رموز جديدة في مواضع رموز غير مُستعملة. مع ذلك، فإن الغايجي ليس نظاما عمليا في بيئة كالإنترنت، حيث يجب تحويل مجموعة الرموز إلى نص ليتم استخدام الغايجي. نتيجة لذلك، تُكتب هذه الرموز باستخدام رموز أخرى مشابهة أو مبسطة للرموز الأصلية، ذلك أو يتوجب تشفير النص باستخدام نظام رموز أكبر (مثل الترميز الموحد) تدعم الرموز المطلوبة.
وفي هذا السياق، حتى عام 2000، كانت أغلب رسائل البريد الإلكترونية تستعمل ISO-2022-JP (أي تشفير JIS) بينما استعملت أغلب مواقع الإنترنت Shift-JIS، واستعملت أغلب الهواتف المحمولة في اليابان شكلا من أشكال Extended Unix Code. إذا لم ينجح الحاسوب في تحديد مخطط التشفير المناسب فهذا يتسبب بظهور ما يسمى «موجيباكي» والذي يؤدي إلى ظهور رموز غير مقروءة على الشاشة.
في هذا الإطار، على الجانب الآخر، فإن نظام EUC يتعامل بشكل أفضل مع المحلل الذي تم تطويره لنظام 7-bit ASCII. لكن لسوء الحظ، فإن EUC غير مطوّر ليكون متوافقا مع JIS X 0201.
كذلك، بدأ الانقسام بين الانظمة المستعملة في الأجهزة عندما بدأ تطوير أنظمة تشفير داعمة للكانجي. يدعم نظام Shift-JIS رموز الكانجي، كما أنّه مصمم ليكون متوافقا مع نظام JIS X 0201، بالتالي فقد أصبح مدمجا في أغلب الأجهزة الإلكترونية. مع ذلك فإن Shift JIS يعاني من مشكلة واحدة وهي أنه يوقف عمل أي محلل (برنامج يقرأ النص المشفر) غير المصمم خصيصا للتعامل معه.
علاوةً على ذلك، كما تنشأ المزيد من المشكلات عند التعامل مع البريد الإلكتروني، حيث أن نموذج البريد الإلأكتروني الأصلي على الإنترنت لا يدعم سوى بروتوكولات النقل ذات 7 بتات. بالتالي فقد تم تطوير نظام RFC 1468 بهدف إرسال واستقبال رسائل البريد الإلكتروني.
إضافةً إلى ذلك، تم تطوير الترميز الموحد بهدف حل جميع مشاكل التشفير الخاصة بجميع اللغات. نظام UTF-8 المستعمل لتشفير الترميز الموحد في المواقع الإلكترونية لا يعاني من المشكلات التي يعاني منها Shift-JIS. نظام الترميز الموحد مدعوم من خلال برمجية عالمية لا تستوجب استعمال الغايجي. مع ذلك، فإن هذا النظام قد تسبب ببعض الخلافات. في هذا النظام تم توحيد رموز الكانجي مع الرموز الصينية؛ أي أن الرموز التي تعتبر متشابهة في اللغتين يتم إعطاؤها رقماً واحداً للتشفير، حتى لو وُجد اختلاف بسيط في الشكل. تسمى هذه العملية بعملية «توحيد الهان»، والتي قد تسببت بالخلافات. أنظمة التشفير السابقة تعاملت مع الرموز اليابانية والتايوانية والصينية والكورية كلاً على حدا، بينما تحاول الترميز الموحد التعامل معها كلها. ورغم الخلافات، فإن عملية التوحيد بين الصينية والكانجي تمت من خلال لجنة مكونة من مصممين ممثلين للدول الأربعة.
كذلك، أول نظام تشفير تم استعمله على نطاق واسع كان JIS X 0201، وهو تشفير أحادي البايب، يغطي أحرف الأسكي التي تستعمل 7 بتات ورموز الكانا المضغوطة بنصف عرضها. هذا النظام المستعمل لم يكن قويا بما فيه الكفاية، كما أنه لم يحتو على مساحة تخزن كافية للتعامل مع رموز الكانجي، وذلك لإن عملية تحويل الكانا إلى كانجي عملية معقدة، كما أن طباعة رموز الكانجي تتطلب مساحة تخزين أكبر من الموجودة بكثير. مما يعني أن الأجهزة التي استعملت هذا النظام كانت تدعم الكاتاكانا فقط، بعيدا عن الكانجي. على الرغم من ذلك لا تزال بعض شاشات العرض تستعمل هذا النظام، متعرضة لهذا النوع من التقييد في الإدخال.
اتجاه النص
وعلى صعيد آخر، تُكتب اليابانية باتجاهين. إما بإسلوب yokogaki الذي يُكتب من اليسار إلى اليمين ثم الأعلى إلى الأسفل كالإنجليزية، أو أسلوب tategaki الذي بُكتب أولاً من الأعلى إلى الأسفل ثم ينتقل من اليمين إلى اليسار.
وعلى صعيد آخر، في الوقت الحالي، لا يزال دعم النصوص المكتوبة لأسفل غير مكتملاً. مثلًا، فإن HTML لا تدعم أسلوب كتابة الـ tategaki لذلك يضطر مستعملو اللغة اليابانية من استخدام جداول HTML لمحاكاة هذا الأسلوب الكتابي. مع ذلك، فيتضمن CSS level 3 خاصية "writing-mode" والتي يمكنها عرض أسلوب كتابة الـ tategaki عند إعطائها قيمة "vertical-rl" (i.e. top to bottom، right to left)..
كذلك، للتنافس مع Ichitaro (معالج كلمات ياباني طوّرته JustSystems)، قدمت مايكروسوفت الكثير من التحديثات للإصدارات اليابانية المبكرة من مايكروسوفت وورد، والتي كانت تدعم النصوص المكتوبة من أعلى إلى أسفل، مثل Word 5.0 Power Up Kit وWord 98.
من جانب آخر، كان برنامج QuarkXPress أكثر برامج الـ DTP شهرة في اليابان في التسعينات، مع ذلك، نظراً لعدم دعمها للنصوص المكتوبة من الأعلى للأسفل فقد تجاوزه نظام Adobe InDesign الذي كان يدعم النصوص المكتوبة من الأعلى إلى أسفل بقوّة في الكثير من تحديثاته.
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟