تتابع الحمض النووي الريبي RNA
المحتويات
- تطبيقات
- الإجراءات التجريبية
- كشف الجينات الانصهار
- إعداد متسلسل
- الاعتبارات التجريبية
- جهود التسلسل الجيني على نطاق واسع
- تسلسل الحمض النووي الريبي rRNA المباشر
- شبكات التعبير (النسخ) المساعد
- التجمع النسخي
- تطبيقات على الطب
- التعبير الجيني الكمي
- اكتشاف البديل
- RNA صغير / غير مرموز لتسلسل RNA
- التاريخ
- الربط البديل
- التعبير (النسخ) التفاضلي
- الكم المطلق
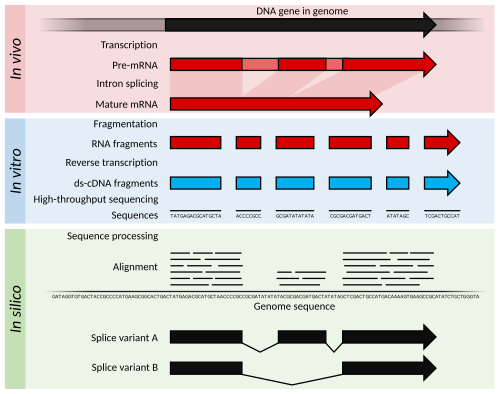
على سبيل التعريف، يستعمل RNA-Seq تسلسل الجيل التالي (NGS) للكشف عن وجود وكمية من الحمض النووي الريبي في عينة بيولوجية في لحظة معينة، وتحليل المتغير الخلوي المستمر. ونتناول فيما يلي مزيدًا من التفاصيل.
في هذا الإطار، على وجه التحديد، يسهل RNA-Seq القدرة على النظر إلى الجينات البديلة المقسمة، والتعديلات بعد النسخ، والانصهار الجيني، والطفرات / SNPs والتغيرات في التعبير الجيني مع مرور الوقت، أو الاختلافات في التعبير الجيني في مجموعات أو علاجات مختلفة. فضلًا عن نسخ mRNA، يمكن أن ينظر RNA-Seq إلى مجموعات مختلفة من الحمض النووي الريبي (RNA) لتشمل إجمالي الحمض النووي الريبي (RNA)، والحمض النووي الريبي (RNA) الصغير، مثل miRNA، الحمض الريبي النووي النقال (tRNA)، وتحديد ملامح الريبوسوم. يمكن كذلك استخدام RNA-Seq لتحديد حدود exon / intron والتحقق من أو تعديل حدود الجين الموضحة مسبقًا 5 و3. تشمل التطورات الحديثة في RNA-Seq سلسلة الخلية الواحدة وتسلسل الأنسجة الثابتة في الموقع.
الأساليب
علاوةً على ذلك، قبل RNA-Seq، أجريت دراسات التعبير الجيني مع المصفوفات الدقيقة القائمة على التهجين. تشمل مشاكل المصفوفات الدقيقة القطع الجينية المتقاطعة، التهميش السيئ للجينات منخفضة الوزن وعالية التعبير، والحاجة إلى معرفة التسلسل المسبق. بسبب هذه المشكلات الفنية، انتقلت النصوص إلى الأساليب القائمة على التسلسل. لقد تطورت هذه من تسلسل Sanger في مكتبات Expressed Sequence Tag، إلى الأساليب القائمة على العلامات الكيميائية (مثلًا، التحليل التسلسلي للتعبير الجيني)، وأخيراً إلى التكنولوجيا الحالية، تسلسل الجيل القادم من cDNA (خاصة RNA-Seq).
تطبيقات
وفي هذا السياق، قدمت scRNA-Seq نظرة ثاقبة كبيرة في تطور الأجنة والكائنات الحية، بما في ذلك دودة Caenorhabditis elegans ، والمستوصف الشمسي التجديدي المتوسطي . كانت أول الحيوانات الفقارية التي تم تعيينها بهذه الطريقة هي الزرد و Xenopus laevis. في كل حالة، تمت دراسة مراحل متعددة من الجنين، مما يسمح برسم عملية التنمية بأكملها على أساس كل خلية على حدة. لقد أدرك العلم أن هذه التطورات هي " اختراق العام 2018 ".
كذلك، أصبح scRNA-Seq يستعمل على نطاق واسع عبر التخصصات البيولوجية بما في ذلك التنمية، وعلم الأعصاب، علم الأورام، مرض المناعة الذاتية، والأمراض المعدية.
الإجراءات التجريبية
من جانب آخر، في سنة 2017، تم تقديم طريقتين لقياس في وقت واحد مرنا وحيد الخلية وتعبير البروتين من خلال الأجسام المضادة المسمى أليغنوكليوتيد المعروفة باسم REAP-seq ، و CITE-seq.
من جهة ثانية، تشمل تحديات scRNA-Seq الحفاظ على الوفرة النسبية الأولية للـ mRNA في الخلية وتحديد النصوص النادرة. تعتبر خطوة النسخ العكسي أمرًا بالغ الأهمية نظرًا لأن كفاءة رد فعل RT تحدد مقدار تحليل الحمض النووي الريبي للخلية الذي سيتم تحليله في نهاية الأمر بواسطة جهاز التسلسل. قد تؤثر قابلية النسخ العكسي واستراتيجيات التحضير المستعملة على إنتاج cDNA كامل الطول وتوليد مكتبات منحازة نحو نهاية 3 أو 5 'من الجينات.
إضافةً إلى ذلك، في خطوة التضخيم، يتم الآن استخدام PCR أو في النسخ المختبرية (IVT) لتضخيم cDNA واحدة من مزايا الأساليب القائمة على PCR هي القدرة على توليد cDNA كامل الطول. ومع ذلك، قد يتم تضخيم كفاءة PCR مختلفة على تسلسلات معينة مثلًا، محتوى GC وهيكل snapback إلى حدّ كبير، مما ينتج مكتبات ذات تغطية غير متساوية. من ناحية أخرى، في حين أن التسلسلات التي تم إنشاؤها بواسطة IVT يمكنها تجنب تحيز التسلسل الناتج عن PCR، فقد يتم نسخ تسلسلات محددة بطريقة غير فعالة، مما يسبب تسلسل المتسلسل أو توليد تسلسلات غير مكتملة. تم نشر الكثير من بروتوكولات scRNA-Seq: Tang et al. STRT. STRT ، SMART-seq ، CEL-seq ، RAGE-seq ، ، Quartz-seq. و C1-CAGE. من حيث استراتيجيات النسخ العكسي، وتوليف cDNA والتضخيم، وإمكانية استيعاب الباركود الخاصة بالتسلسل مثل UMIs أو القدرة على معالجة العينات المجمعة.
وفي السياق ذاته، تتضمن بروتوكولات scRNA-Seq الحالية الخطوات التالية: عزل خلية واحدة وRNA، النسخ العكسي (RT)، والتضخيم، وتوليد التسلسل، والتسلسل. طرق مبكرة فصل الخلايا الفردية إلى آبار منفصلة. طرق أكثر حداثة تغلف الخلايا الفردية في قطرات في جهاز ميكروفلويديك، حيث يحدث رد فعل النسخ العكسي، وتحويل الحمض النووي الريبي إلى cDNAكل قطرة تحمل «الباركود» DNA الذي يسمي بشكل فريدcDNA المستمدة من خلية واحدة. بمجرد اكتمال النسخ العكسي، يمكن خلط cDNAمن الكثير من الخلايا معًا للتسلسل؛ يتم التعرف على النصوص من خلية معينة بواسطة الرمز الشريطي الفريد.
كشف الجينات الانصهار
كذلك، وتأتي الفكرة من عملية محاذاة القراءات النصية القصيرة إلى الجينوم المرجعي. ستقع أغلب القراءات القصيرة ضمن إكسون واحد كامل، ومن المتوقع أن تحدد مجموعة أصغر ولكن لا تزال كبيرة على تقاطعات إكسون المعروفة. عندئذٍ، سيتم تحليل القراءات القصيرة المتبقية غير المعينة لتحديد ما إذا كانت تتطابق مع تقاطع إكسون حيث يأتي الإكسون من جينات مختلفة. قد يكون هذا دليلًا على حدوث اندماج محتمل، ولكن نظرًا لطول القراءات، فقد يكون هذا مزدحم للغاية. هناك طريقة بديلة تتمثل في استخدام قراءات نهاية الزوج، عندما يقوم عدد كبير يحتمل من القراءات المقترنة بتعيين كل طرف إلى إكسون مختلف، مما يوفر تغطية أفضل لهذه الأحداث ومع ذلك، فإن النتيجة النهائية تتكون من مجموعات متعددة وربما جديدة من الجينات توفر نقطة انطلاق مثالية لمزيد من التحقق من الصحة.
كذلك، بسبب التعديلات الهيكلية المختلفة في الجينوم، اكتسبت جينات الاندماج الانتباه بسبب علاقتها بالسرطان. إن قدرة RNA-Seq على تحليل النص الكامل للعينة بطريقة غير متحيزة تجعلها أداة جذابة للعثور على هذه الأنواع من الأحداث الشائعة في السرطان.
إعداد متسلسل
في هذا الإطار، الخطوات العامة لإعداد متسلسل DNA (cDNA) التكميلية للتسلسل موضحة أسفل، ولكن غالبًا ما تختلف بين المنصات.
وفي هذا السياق، تخليق cDNA: يتم نسخ RNA إلى cDNA لأن الحمض النووي أكثر استقرارًا ويسمح بالتضخيم (عن طريق polymerases الحمض النووي) وتقنية تسلسل الحمض النووي أكثر نضجًا. يؤدي التضخيم اللاحق للنسخ العكسي إلى فقد السبل، والتي يمكن تجنبها بالوسم الكيميائي أو تسلسل جزيء واحد. يتم تنفيذ تجزئة واختيار الحجم لتنقية التسلسلات التي هي الطول المناسب لآلة التسلسل. الحمض النووي الريبيrRNA، cDNA, أو كليهما مجزأ مع الإنزيمات، صوتنه، أو البخاخات. يعمل تجزئة الحمض النووي الريبي على تقليل انحياز 5 'من النسخ العكسي العشوائي وتأثير مواقع الربط التمهيدي، مع الجانب الذي ينتهي به الطرفان 5 و3 إلى الحمض النووي أقل كفاءة. يتبع التجزؤ اختيار الحجم، حيث تتم إزالة تسلسلات صغيرة أو تحديد نطاق ضيق من أطوال التسلسل. بسبب ضياع rRNA الصغيرة مثل miRNAs، يتم تحليلها بشكل مستقل. يمكن فهرسة cDNA لكل تجربة مع الباركود hexamer أو octamer، بحيث يمكن تجميع هذه التجارب في مسار واحد لتسلسل متعدد الإرسال.
وفي السياق ذاته، اختيار / نضوب الحمض النووي الريبي: لتحليل إشارات الاهتمام، يمكن إما الاحتفاظ بالحمض النووي الريبي المعزول كما هو، مع ترشيح الحمض النووي الريبي مع ذيول متعددة الأقطاب (3) متعددة (poly (A) لتشمل فقط rRNA، المستخلص من الحمض النووي (rRNA)، و / أو تمت تصفيته من أجل الحمض النووي الريبي (RNA) الذي يربط تسلسلات محددة (جدول اختيار ونضج الحمض النووي الريبي، أسفل). الحمض النووي الريبي مع ذيول 3 '(بولي) الناضجة، والمعالجة، والتابعة لتسلسل الترميز. يتم اختيار (Poly A) عن طريق مزج الحمض النووي الريبي (RNA) مع قلة قليلة من القسيمات (T) المرتبطة تساهميًا بالركيزة، الخرز المغناطيسي عادة. يتجاهل اختيار (Poly A) الحمض النووي الريبي غير المشفر ويقدم تحيزًا 3 '، والذي يتم تجنبه باستراتيجية نضوب الريبوسوم. تتم إزالة rRNA لأنه يمثل أكثر من 90 ٪ من الحمض النووي الريبي في الخلية، والتي إذا تم الاحتفاظ بها سوف تتخلص من البيانات الأخرى.
من جهة ثانية، عزل الحمض النووي الريبي (RNA): يتم عزل الحمض النووي الريبي (RNA) من الأنسجة ويخلط مع (DNase) DNase يقلل من كمية الحمض النووي الجيني. يتم ضبط الكمية المفككة من الحمض النووي الريبي مع هلام والخلاصة التحليل الكهربي لمحتوى الشعيرات الدموية ويستعمل لتعيين عدد سلامة الحمض النووي الريبي للعينة. تؤخذ جودة الحمض النووي الريبي (RNA) والمبلغ الإجمالي لبدء الحمض النووي الريبي (RNA) في الاعتبار أثناء خطوات إعداد وتسلسل وتحليل المكتبة اللاحقة.
الاعتبارات التجريبية
علاوةً على ذلك، نوعية الأنسجة: يختلف التعبير الجيني داخل الأنسجة وفيما بينها، ويقيس RNA-Seq هذا المزيج من أنواع الخلايا. هذا قد يجعل من الصعب عزل الآلية البيولوجية للاهتمام. يمكن استخدام تسلسل خلية واحدة لدراسة كل خلية على حدة، وتخفيف هذه المشكلة.
ومن جهة أخرى، الاعتماد على الوقت: يتغير تعبير الجينات بمرور الوقت، ولا يأخذ RNA-Seq سوى لقطة. يمكن إجراء تجارب الدورة الزمنية لمراقبة التغييرات في النص الجيني.
من جهة ثانية، إدارة البيانات: عادة ما تكون تجربة RNA-Seq في البشر في حدود 1 غيغابايت. هذا الحجم الكبير من البيانات يمكن أن يطرح مشاكل التخزين. أحد الحلول هو ضغط البيانات باستخدام مخططات حسابية متعددة الأغراض (مثلًا، gzip أو مخططات خاصة بالجينوم. هذا الأخير يمكن أن يكون على أساس تسلسل مرجعي أو دي نوفو. الحل الآخر هو إجراء تجارب ميكروأري، والتي قد تكون كافية لإجراء الدراسات التي تعتمد على الفرضيات أو تكرارها على عكس البحوث الاستكشافية.
في هذا الإطار، التغطية (المعروف كذلك باسم العمق): يحتوي الحمض النووي الريبي على نفس الطفرات التي لوحظت في الحمض النووي، ويتطلب الكشف تغطية أعمق. مع تغطية عالية بما فيه الكفاية، يمكن استخدام RNA-Seq لتقدير التعبير عن كل أليل. قد يوفر هذا نظرة ثاقبة الظواهر مثل التأثيرات أو التأثيرات التنظيمية. يمكن استقراء عمق التسلسل المطلوب لتطبيقات محددة من تجربة تجريبية.
التحليل
وعلى صعيد آخر، يتم مراعاة مجموعة متنوعة من المعلمات عند تصميم وإجراء تجارب RNA-Seq:
علاوةً على ذلك، قطع لتوليد البيانات (تُعرف كذلك باسم التباين التقني): يمكن أن تؤدي الكواشف (مثلًا، مجموعة إعداد التسلسل) والموظفين المعنيين ونوع جهاز التسلسل مثلًا، Illumina وPacific Biosciences إلى آثار فنية قد يساء تفسيرها على أنها نتائج ذات معنى. كما هو الحال مع أي تجربة علمية، من الحكمة إجراء RNA-Seq في بيئة جيدة التحكم. إذا لم يكن ذلك ممكنًا أو كانت الدراسة عبارة عن تحليل تلوي، فإن الحل الآخر هو اكتشاف القطع الفنية عن طريق استنتاج المتغيرات الكامنة (عادة تحليل المكون الرئيسي أو تحليل العوامل) والتصحيح لاحقًا لهذه المتغيرات.
جهود التسلسل الجيني على نطاق واسع
في هذا الإطار، تم التركيز إلى حدّ كبير على بيانات RNA-Seq بعد أن استعملت مشاريع موسوعة عناصر الحمض النووي (ENCODE) وأطلس سرطان الجينوم (TCGA) هذا النهج لتوصيف عشرات من خطوط الخلايا وآلاف من عينات الورم الأولية، على التوالي. تهدف ENCODE إلى تحديد المناطق التنظيمية على نطاق الجينوم في مجموعة مختلفة من خطوط الخلايا والبيانات transcriptomic هي الأهم من أجل فهم تأثير المصب لتلك الطبقات التنظيمية الجينية والوراثية. يهدف TCGA، بدلاً من ذلك، إلى جمع وتحليل آلاف من عينات المرضى من 30 نوعًا مختلفًا من الأورام من أجل فهم الآليات الأساسية للتحول والتطور الخبيث. في هذا السياق، توفر بيانات RNA-Seq لقطة فريدة للحالة النصية للمرض وتنظر إلى مجموعة غير متحيزة من النصوص التي تسمح بتحديد النصوص الجديدة ونصوص الاندماج وRNA غير المشفرة التي يمكن اكتشافها باستخدام تقنيات مختلفة.
تسلسل الحمض النووي الريبي rRNA المباشر
تسلسل RNA أحادي الخلية (scRNA-Seq)
كذلك، نظرًا لأن تحويل الحمض النووي الريبي إلى الحمض النووي الريبي النووي (cDNA)، فقد ثبت أن عمليات الربط، والتضخيم، والتلاعب بالعينات الأخرى تقدم تحيزات وأدوات أثرية قد تتداخل مع كل من التوصيف الصحيح والتابعات الصحيحة للنصوص الجينية، تم استكشاف تسلسل الحمض النووي الريبي المباشر للجزيء المفرد [13] ، بما في ذلك Helicos (المفلسة)، أوكسفورد نانوبور تكنولوجيز، وغيرها. هذه التكنولوجيا تسلسل جزيئات الحمض النووي الريبي مباشرة بطريقة موازية على نطاق واسع.
كذلك، يوفر تسلسل الحمض النووي الريبي أحادي الخلية (scRNA-Seq) ملفات تعريف للخلايا الفردية. على الرغم من أنه لا يمكن الحصول على معلومات كاملة عن كل RNA الذي يعبر عن كل خلية، نظرًا للكمية الضئيلة من المواد المتاحة، يمكن التعرف على أنماط التعبير الجيني من خلال تحليلات تجميع الجينات. هذا يمكن أن يكشف عن وجود أنواع خلايا نادرة داخل مجتمع الخلية والتي ربما لم يسبق رؤيتها من قبل. مثلًا، تم تحديد خلايا متخصصة نادرة في الرئة تدعى الخلايا الأيونية الرئوية التي تعبر عن منظم توصيل غشاء التليف الكيسي في 2018 من قبل مجموعتين تؤديان ال rRna ساق على ظهارة مجرى الرئة.
ومن ناحية أخرى، الطرق القياسية مثل المصفوفات الدقيقة وتحليل المعيار RNA-Seq يحلل تعبير ال rRNA من مجموعات كبيرة من الخلايا. في مجموعات الخلايا المختلطة، قد تحجب هذه القياسات الفروق الحرجة بين الخلايا الفردية داخل هذه المجموعات.
شبكات التعبير (النسخ) المساعد
وفي السياق ذاته، شبكات التعبير (النسخ) المساعد هي تمثيلات مستمدة من البيانات من الجينات تتصرف بطريقة مماثلة عبر الأنسجة والظروف التجريبية. يكمن هدفهم الرئيسي في توليد الفرضيات وأساليب الذنب من جانب الجمعيات لاستنتاج وظائف الجينات غير المعروفة سابقًا. تم استخدام بيانات RNA-Seq لاستنتاج الجينات المشاركة في مسارات محددة تعتمد على ارتباط بيرسون، سواء في النباتات والثدييات. الميزة الرئيسية لبيانات RNA-Seq في هذا النوع من التحليل عبر منصات ميكروأري هي القدرة على تغطية النص بأكمله، مما يتيح إمكانية كشف تمثيلات أكثر اكتمالا لشبكات تنظيم الجينات. يمكن الكشف عن التنظيم التفريقي لعناصر الشكل العظمية للجنس نفسه واستخدامها للتنبؤ ووظائفها البيولوجية. تم بنجاح استخدام تحليل شبكة التعبير المشترك للجينة الموزونة لتحديد الوحدات النمطية للتعبير المشترك والجينات المحورية داخل العضل على بيانات الحمض النووي الريبي. قد تتوافق وحدات التعبير المشترك مع أنواع الخلايا أو المسارات. يمكن تفسير لوحات الوصل الفائقة المتصلة ببعضها البعض كممثلين لوحدة كل منها. إن eigengene هو عبارة عن مجموع مرجح للتعبير عن جميع الجينات في وحدة نمطية. Eigengenes هي علامات حيوية مفيدة (ميزات) للتشخيص والتشخيص. تم اقتراح مناهج تحويل التباين المستقر لتقدير معاملات الارتباط بناءً على بيانات RNA seq.
التجمع النسخي
من جانب آخر، ملاحظة على جودة التجميع: الإجماع الحالي هو أن 1) يمكن أن تختلف جودة التجميع تبعًا للمقياس المستعمل، 2) التجميعات التي سجلت جيدًا في أحد الأنواع لا تؤدي بالضرورة أداءً جيدًا في الأنواع الأخرى، و3) قد يؤدي الجمع بين الطرق المختلفة إلى كن الأكثر موثوقية.
في هذا الإطار، دي نوفو: هذا النهج لا يحتاج إلى جينوم مرجعي لإعادة بناء النص، ويستعمل عادة إذا كان الجينوم غير معروف، غير مكتمل، أو تم تغييره إلى حدّ كبير مقارنة بالمرجع. تتضمن التحديات عند استخدام عمليات القراءة القصيرة لتجميع de novo 1)) تحديد القراءات التي يجب ضمها معًا في تسلسلات متجاورة contigs)، 2) متانة أخطاء التسلسل وغيرها من الأعمال الفنية، و3 الكفاءة الحسابية. تم نقل الخوارزمية الأساسية المستعملة لتجميع de novo من الرسوم البيانية المتداخلة، والتي تحدد جميع التداخلات بين الزوجين إلى القراءات، إلى الرسوم البيانية لـ Bru Brunn، والتي تقسم القراءة إلى تسلسلات طولها k وتنهار كل k-mers في جدول تجزئة. تم استخدام الرسوم البيانية المتداخلة مع تسلسل Sanger، لكن لا يتم القياس جيدًا إلى ملايين القراءات التي تم إنشاؤها باستخدام RNA-Seq. أمثلة على المجمعات التي تستعمل الرسوم البيانية دي Bruijn هي Velvet ، Trinity ، Oases ، و Bridger. يمكن للنهاية المزدوجة وتسلسل القراءة الطويلة من نفس العينة أن يخففا من العجز في تسلسل القراءة القصيرة من خلال العمل كقالب أو هيكل عظمي. تشتمل مقاييس تقييم جودة مجموعة de novo على متوسط طول contig وعدد contigs و N50.
في هذا الإطار، يتم استخدام طريقتين لتعيين تسلسلات القراءة الأولية للميزات الجينومية (أي تجميع النص الجيني):
كذلك، دليل الجينوم: تعتمد هذه الطريقة على نفس الأساليب المستعملة لمحاذاة الحمض النووي، مع التعقيد الإضافي المتمثل في محاذاة القراءات التي تغطي أجزاء غير مستمرة من الجينوم المرجعي. هذه القراءات غير المستمرة هي نتيجة لتسلسل النصوص المقسمة (انظر الشكل). عادة، تحتوي خوارزميات المحاذاة على خطوتين: 1) محاذاة أجزاء قصيرة من القراءة (أي، بداية الجينوم)، و 2) استخدام البرمجة الديناميكية لإيجاد محاذاة مثالية، وأحيانًا بالاقتران مع تعليقات توضيحية معروفة. تشمل أدوات البرمجيات التي تستعمل المحاذاة الموجهة للجينوم Bowtie ، TopHat (الذي يبني على نتائج BowTie لمحاذاة الوصلات الفاصلة)، Subread ، STAR ، HISAT2 ، Sailfish ، كاليستو، و GMAP. يمكن قياس جودة التجميع الموجه للجينوم بمقاييس التجميع 1) de novo (مثلًا، N50) و 2) مقارنات بالتسلسلات المعروفة، تقاطع الوصلات، الجينوم، والبروتين باستخدام الدقة ، الاستعادة، أو توليفها (مثلًا، النتيجة F1). علاوةً على ذلك، يمكن إجراء تقييم السيليكو باستخدام قراءات محاكية.
تطبيقات على الطب
في هذا الإطار، RNA-Seq لديه القدرة على تحديد البيولوجيا المرضية الجديدة ، المؤشرات الحيوية الشخصية للمؤشرات السريرية ، استنتاج مسارات قابلة للتخدير ، وجعل التشخيص الوراثي. يمكن تخصيص هذه النتائج بشكل أكبر للمجموعات الفرعية أو حتى للمرضى الأفراد، مما قد يؤدي إلى تسليط الضوء على المزيد من الوقاية الفعالة والتشخيص والعلاج. تملي جدوى هذا النهج جزئياً التكاليف في المال والوقت؛ أحد القيود ذات الصلة هو فريق المتخصصين المطلوب (خبراء المعلومات الحيوية والأطباء / الأطباء والباحثون الأساسيون والفنيون) لتفسير كامل الكم الهائل من البيانات الناتجة عن هذا التحليل.
التعبير الجيني الكمي
إضافةً إلى ذلك، يتم تحديد التعبير عن طريق حساب عدد القراءات التي تم تعيينها لكل موقع في خطوة التجميع transcriptome. يمكن قياس التعبير عن الإكسونات أو الجينات باستخدام contigs أو التعليقات التوضيحية المرجعية. تم التحقق من صحة تعدادات RNA-Seq التي تمت ملاحظتها بقوة ضد التقنيات القديمة، بما في ذلك المصفوفات الدقيقة التعبير وqPCR . من الأمثلة على الأدوات التي تحدد التعدادات HTSeq ، FeatureCounts ، Rcount ، maxcounts ، FIXSEQ ، و Cuffquant. ثم يتم تحويل عدد القراءة إلى مقاييس مناسبة لاختبار الفرضيات والانحدارات والتحليلات الأخرى. المعلمات لهذا التحويل هي:
إضافةً إلى ذلك، العمق / التغطية المتسلسلة: على الرغم من أن العمق محدد مسبقًا عند إجراء تجارب RNA-Seq متعددة، إلا أنه سيظل متباينًا على نطاق واسع بين التجارب. لذلك، عادةً ما يتم تطبيع إجمالي عدد القراءات التي تم إنشاؤها في تجربة واحدة عن طريق تحويل التعدادات إلى أجزاء أو قراءات أو تعدادات لكل مليون قراءة معيّنة FPM أو RPM أو CPM يشار إلى عمق التسلسل أحيانًا بحجم المكتبة، وعدد جزيئات cDNA الوسيطة في التجربة.
ومن جهة أخرى، طول الجينات: سيكون للجينات الأطول شظايا / قراءات / تعدادات أكثر من الجينات الأقصر إذا كان تعبير النص الجيني هو نفسه. يتم ضبط هذا عن طريق تقسيم FPM على طول الجين، مما يؤدي إلى شظايا متري لكل كيلوبايت من النص لكل مليون قراءة المعينة (FPKM). عند النظر إلى مجموعات من الجينات عبر العينات، يتم تحويل FPKM إلى نصوص لكل مليون (TPM) عن طريق تقسيم كل FPKM على مجموع FPKMs داخل عينة.
كذلك، تباين تعبير كل جين: يتم تصميمه ليتم حسابه على خطأ أخذ العينات (مهم للجينات ذات التعداد المنخفض للقراءة)، ويزيد الطاقة، ويقلل من الإيجابيات الخاطئة. يمكن تقدير التباين كتوزيع طبيعي، أو بواسون، أو سلبي ذو حدين وغالبًا ما يتحلل إلى تباين تقني وبيولوجي.
ومن جهة أخرى، يتم التعبير عن التعبير الكمي لدراسة التغيرات الخلوية استجابةً للمنبهات الخارجية، الاختلافات بين الحالات الصحية والمرضية، وغيرها من الأسئلة البحثية. غالبًا ما يستعمل تعبير الجين كبديل لوفرة البروتين، لكن غالبًا ما تكون هذه العناصر غير متكافئة بسبب أحداث ما بعد النسخ مثل تدخل الحمض النووي الريبي وانحلال بوساطة الهراء.
وفي السياق ذاته، مجموع عينة الحمض النووي الريبي: لأن نفس كمية الحمض النووي الريبي المستخرجة من كل عينة، فإن العينات ذات الحمض النووي الريبي الإجمالي أكثر سيكون لها عدد أقل من الحمض النووي الريبي لكل جين. يبدو أن هذه الجينات قد قللت من التعبير، مما أدى إلى إيجابيات كاذبة في التحليلات النهائية.
اكتشاف البديل
ومن جهة أخرى، يلتقط RNA-Seq تباين الحمض النووي، بما في ذلك متغيرات النوكليوتيدات الفردية والإدخالات الصغيرة / الحذف. والتباين الهيكلي. يشبه استدعاء المتغير في RNA-Seq استدعاء متغير الحمض النووي، وغالبًا ما يستعمل نفس الأدوات (بما في ذلك SAMtools mpileup و GATK HaplotypeCaller ) مع تعديلات لحساب الربط. أحد الأبعاد الفريدة لمتغيرات الحمض النووي الريبي هو التعبير الخاص بالأليل (ASE): قد يتم التعبير عن المتغيرات من النمط الفرداني واحد بشكل تفضيلي بسبب التأثيرات التنظيمية بما في ذلك البصمة والتعبير عن موقع السمات الكمية، والمتغيرات النادرة غير المشفرة. تتضمن حدود تحديد متغير الحمض النووي الريبي (RNA) أنه يعكس فقط المناطق المعبر عنها (عند البشر، <5٪ من الجينوم) ولديه جودة أقل مقارنة بتسلسل الحمض النووي المباشر.
تحرير الحمض النووي الريبي (التعديلات بعد النسخ)
ومن ناحية أخرى، يمكن أن يساعد وجود تسلسلات مطابقة للجينوم والنسخ للفرد في الكشف عن التعديلات بعد النسخ (تحرير RNA). يتم تحديد حدث تعديل ما بعد النسخ إذا كان نص الجين يحتوي على أليل / متغير لم يلاحظ في البيانات الجينية.
RNA صغير / غير مرموز لتسلسل RNA
وعلى صعيد آخر، عند إجراء تسلسل RNA غير miRNA، يتم تعديل إعداد التسلسل. يتم تحديد الحمض النووي الريبي على أساس نطاق الحجم المطلوب. لأهداف الحمض النووي الريبي الصغيرة، مثل miRNA، يتم عزل الحمض النووي الريبي من خلال اختيار الحجم. يمكن إجراء ذلك باستخدام هلام استبعاد الحجم، من خلال حبات مغناطيسية لاختيار الحجم، أو باستخدام مجموعة تم تطويرها تجاريًا. بمجرد عزلها، تتم إضافة الروابط إلى النهاية 3 'و5' ثم تنقيتها. والخطوة الأخيرة هي الجيل cDNA من خلال النسخ العكسي.
التاريخ
كذلك، تم تطوير RNA-Seq لأول مرة في منتصف عام 2000 مع ظهور تقنية التسلسل من الجيل التالي. تتضمن المخطوطات الأولى التي استعملت RNA-Seq حتى بدون استخدام المصطلح تلك الخاصة بخطوط خلايا سرطان البروستاتا (بتاريخ 2006)، و Medicago truncatula (2006)، والذرة (2007)، و Arabidopsis thaliana (2007)، في حين أن مصطلح "RNA-Seq" نفسه ذكر لأول مرة في عام 2008. يزداد عدد المخطوطات التي تشير إلى RNA-Seq في العنوان أو الملخص (الشكل ، الخط الأزرق) بشكل مستمر مع 6754 مخطوطة نشرت في سنة 2018 (رابط للبحث في PubMed ). تقاطع RNA-Seq والدواء (الشكل ، الخط الذهبي ، رابط البحث في النشرات الطبية PubMed) له مرونة مماثلة. ]
الربط البديل
وفي هذا الصدد، الربط بين الحمض النووي الريبي جزء لا يتجزأ من حقيقيات النوى ويسهم بدرجة كبيرة في تنظيم البروتين وتنوعه، حيث يحدث في أكثر من 90 ٪ من الجينات البشرية. هناك عدة طرق بديلة للتشكيل: تخطي exon وضع الربط الأكثر شيوعًا في البشر ونواة حقيقيات النوى أعلى، exons حصرية متبادلة، ومتبرع بديل أو مواقع متقبلة، والاحتفاظ بالإنترون (وضع الربط الأكثر شيوعًا في النباتات، والفطريات، والبروتوزوا) الموقع (المروج)، والبوليدينيل البديل. أحد أهداف RNA-Seq هو تحديد أحداث الربط البديلة والاختبار إذا كانت تختلف بين الظروف. تسلسل القراءة الطويلة يلتقط النص الكامل، وبالتالي يقلل من الكثير من القضايا في تقدير وفرة isoform، مثل تعيين قراءة غامضة. بالنسبة لقراءة RNA-Seq القصيرة، هناك طرق متعددة لاكتشاف الربط البديل الذي يمكن تصنيفه إلى ثلاث مجموعات رئيسية:
في هذا الإطار، قائم على Isoform (كذلك وحدات متعددة القراءة ، التعبير التفاضلي isoform) : تقدير الوفرة isoform أولاً ، ثم الوفرة النسبية بين الشروط. الأمثلة على ذلك هي Cufflinks 2 و DiffSplice.
ومن ناحية أخرى، الختان على أساس Intron: حساب الربط البديل باستخدام تقسيم القراءة. ومن الأمثلة على ذلك MAJIQ و Leafcutter.
وعلى صعيد آخر، قائم على العد (كذلك قائم على الأحداث ، الربط التفاضلي): تقدير استبقاء الإكسون. ومن الأمثلة على ذلك DEXSeq ، MATS ، و SeqGSEA.
كذلك، يمكن كذلك استخدام أدوات التعبير الجيني التفاضلي للتعبير التفاضلي isoform إذا تم قياس الأشكال الإسوية مسبقًا مع أدوات أخرى مثل RSEM.
التعبير (النسخ) التفاضلي
علاوةً على ذلك، الطرق: تستعمل أغلب الأدوات إحصائيات الانحدار أو غير البارامترية لتحديد الجينات التي يتم التعبير عنها تفاضليًا ، وتكون إما قائمة على العد (DESeq2 ، limma ، edgeR) أو قائمة على التجميع (عن طريق القياس الكمي بدون محاذاة ، أو الكلب ، Cuffdiff ، Ballgown ). بعد الانحدار ، تستعمل أغلب الأدوات إما معدل الخطأ العائلي (FWER) أو تعديلات قيمة الاكتشاف الخاطئ (FDR) لمراعاة الفرضيات المتعددة (في الدراسات البشرية ، ~ 20000 من جينات ترميز البروتين أو ~ 50000 نموذج حيوي).
كذلك، إن الاستخدام البسيط والأقوى في كثير من الأحيان لـ RNA-Seq هو إيجاد اختلافات في التعبير الجيني بين شرطين أو أكثر (مثلًا، المعالجة مقابل غير المعالجة)؛ وتسمى هذه العملية التعبير التفاضلي. يشار إلى المخرجات بشكل متكرر على أنها جينات معبر عنها تفاضليًا (DEGs) ويمكن أن يتم تنظيم هذه الجينات إما إلى أعلى أو أسفل (أي، أعلى أو أقل في حالة الاهتمام). هناك الكثير من الأدوات التي تؤدي تعبيرًا تفاضليًا. يتم تشغيل أغلبها في R أو Python أو سطر أوامر Unix . الأدوات الشائعة الاستخدام تشمل DESeq ، edgeR ، و voom + limma ، وكلها متوفرة من خلال موصل R / Bioconductor. هذه هي الاعتبارات الشائعة عند تنفيذ التعبير التفاضلي:
علاوةً على ذلك، تحاليل الدارجة للحصول على قائمة من الجينات المعبر عنها تفاضليًا تأتي في اثنين من النكهات، التحقق من صحة الملاحظات والاستدلال البيولوجي. نظرًا لمخاطر التعبير التفاضلي وRNA-Seq، يتم تكرار الملاحظات المهمة باستخدام (1) طريقة متعامدة في نفس العينات (مثل PCR في الوقت الفعلي) أو (2) تجربة أخرى، مسجلة مسبقًا في بعض الأحيان، في مجموعة جديدة. هذا الأخير يساعد على ضمان التعميم ويمكن متابعته عادةً مع التحليل التلوي لجميع الأفواج المجمعة. الطريقة الأكثر شيوعًا للحصول على فهم بيولوجي عالي المستوى للنتائج هي تحليل التخصيب الجيني، على الرغم من أنه يتم أحيانًا استخدام طرق الجينات المرشحة. يحدد إثراء مجموعة الجينات ما إذا كان التداخل بين مجموعتين من الجينات ذا دلالة إحصائية، وفي هذه الحالة يكون التداخل بين الجينات ومجموعات الجينات التي يتم التعبير عنها تفاضليًا من مسارات / قواعد البيانات المعروفة (مثل، الجينات الأنطولوجية، KEGG، الأنثروبولوجيا البشرية للأنماط) أو من التحليلات التكميلية في التحليل الجيني نفس البيانات (مثل شبكات التعبير المشترك). تشمل الأدوات الشائعة لإثراء مجموعة الجينات واجهات الويب (مثل، ENRICHR، g: profiler) وحزم البرامج. عند تقييم نتائج التخصيب، يكون أحد الأساليب البحثية هو البحث أولاً عن إثراء البيولوجيا المعروفة كتحقق من الصحة ومن ثم توسيع النطاق للبحث عن بيولوجيا جديدة.
ومن جهة أخرى، مطبات: سبب وجود هذه الأساليب المعقدة هو تجنب عدد لا يحصى من المزالق التي يمكن أن تؤدي إلى أخطاء إحصائية وتفسيرات مضللة. المطبات تشمل زيادة معدلات إيجابية كاذبة (بسبب المقارنات المتعددة)، والتحف إعداد العينات، وعدم تجانس العينة (مثل الخلفيات الوراثية المختلطة)، وعينات مترابطة للغاية، في عداد المفقودين للتصاميم التجريبية متعددة المستويات، والتصميم التجريبي الفقراء. أحد الأخطاء البارزة هو عرض النتائج في Microsoft Excel. على الرغم من أنه مناسب، يقوم Excel تلقائيًا بتحويل بعض أسماء الجينات SEPT1 وDEC1 وMARCH2 إلى تواريخ أو أرقام الفاصلة العائمة.
إضافةً إلى ذلك، المدخلات: تشمل مدخلات التعبير التفاضلي (1) مصفوفة تعبير RNA-Seq (جينات M X × عينات) و (2) مصفوفة تصميم تحتوي على ظروف تجريبية لعينات N. تحتوي أبسط مصفوفة التصميم على عمود واحد ، يقابل التسميات للحالة التي يجري اختبارها. يمكن أن تشمل المتغيرات الأخرى (يشار إليها كذلك بعوامل أو ميزات أو تسميات أو معلمات) تأثيرات الدُفعات والمصنوعات المعروفة وأي بيانات وصفية قد تربك أو تتوسط في التعبير الجيني. فضلًا عن المتغيرات المشتركة المعروفة ، يمكن كذلك تقدير المتغيرات المشتركة غير المعروفة من خلال أساليب التعلم الآلي غير الخاضعة للإشراف بما في ذلك تحليلات المكون الرئيسي والمتغير البديل و PEER. غالبًا ما تستعمل التحليلات المتغيرة المخفية لبيانات RNA-Seq الخاصة بالأنسجة البشرية ، والتي تحتوي عادةً على قطع أثرية إضافية لم يتم التقاطها في البيانات الوصفية (مثلًا ، الوقت الإقفاري ، الاستعانة بمؤسسات متعددة ، السمات السريرية الأساسية ، جمع البيانات عبر الكثير من السنوات مع الكثير من الموظفين).
من جانب آخر، اختيار الأدوات والقياس: هناك الكثير من الجهود التي تقارن نتائج هذه الأدوات، حيث تميل DESeq2 إلى التفوق بشكل معتدل على الطرق الأخرى. كما هو الحال مع الطرق الأخرى، يتكون القياس من مقارنة مخرجات الأداة مع بعضها البعض ومعاييرgolden المعروف.
وفي السياق ذاته، المخرجات: يتكون المخرج النموذجي من صفوف تتوافق مع عدد الجينات وثلاثة أعمدة على الأقل، يتغير كل سجل من الجينات (تحويل سجل لنسبة التعبير في الظروف بين، مقياس حجم التأثير)، قيمة p، وp القيمة تعديلها لمقارنات متعددة. يتم تعريف الجينات على أنها ذات معنى من الناحية البيولوجية إذا نجحت في تحديد حجم التأثير (تغيير طية السجل) والأهمية الإحصائية. يجب تحديد هذه القطع بشكل مسبق بشكل مسبق، ولكن طبيعة تجارب RNA-Seq غالبًا ما تكون استكشافية، لذا يصعب التنبؤ بأحجام التأثير والقطع ذات الصلة في وقت مبكر.
الكم المطلق
وفي هذا الصدد، الكم المطلق للتعبير الجيني غير ممكن في أغلب تجارب RNA-Seq، والتي تقيس التعبير بالنسبة لجميع النصوص الجينية. من الممكن عن طريق إجراء RNA-Seq مع spike-ins، عينات من RNA بتركيزات معروفة. بعد التسلسل، يتم استخدام التعدادات المقروءة لتسلسلات الزيادة في تحديد العلاقة بين تعدادات القراءة لكل جين والكميات المطلقة من الأجزاء البيولوجية. في أحد الأمثلة، تم استخدام هذه التقنية في أجنة Xenopus المدارية لتحديد حركية النسخ.
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟