تحقيق أقصى قدر للتوقع (EM)
المحتويات
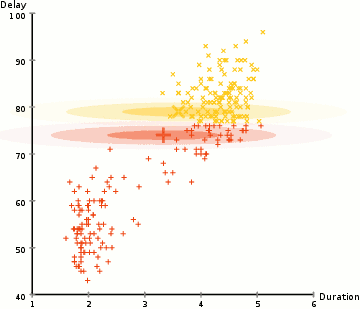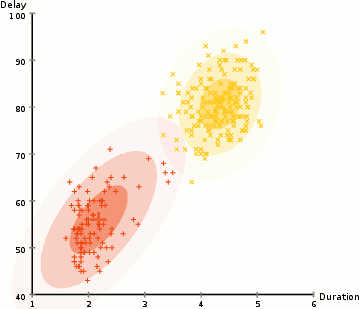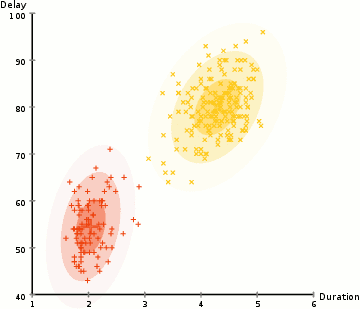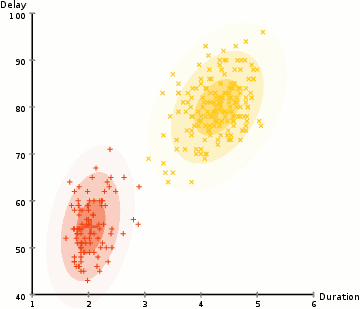
على سبيل التعريف، في الإحصاءات، خوارزمية تحقيق أقصى قدر للتوقع (EM) هي طريقة تكرارية لإيجاد الاحتمال الأقصى الممكن (تقدير الاحتمال) أو أقصى الاحتمال البعدي (MAP) للمعاملات (وسيط (رياضيات)) في النماذج الإحصائية، حيث يعتمد هذا النموذج على المتغيرات الكامنة غير الملحوظة. EM يتمثل في تنفيذ خطوتين: خطوة التوقع (E)، التي ينتج منها توقع للوغاريتم الاحتمال(دالة الإمكان)الأقصى الممكن باستخدام التقدير الحالي للمعلمات، و خطوة تعظيم (M)، التي يحسب فيها المعاملات بحيث يتم تعظيم للوغاريتم المتوقع في الخطوة (E). ثم يتم استخدام هذه المعاملات في تقدير توزيع المتغيرات الكامنة في الخطوة (E) المقبلة. وفيما يلي تفاصيل أوسع عن ذلك.
خوارزميات التصفية والتنعيم باستعمال EM
وفي السياق ذاته، خوارزميات التصفية والتنعيم EM تنشأ من خلال تكرار الخطوتين التاليتين:
علاوةً على ذلك، عادة ما تستعمل مصفاة كالمان (Kalman) للتقدير المباشر للوضعية و يستعمل المنعم ذو التباين الاصغر من اجل التقدير الغير المباشر. ومع ذلك، فان هذه الحلول تتطلب مميزات الوضعية الفضائية للنموذج.لذلك يمكن استخدام خوارزميات EM من أجل حل مشاكل الوضعية المشتركة و تقدير المميزات.
و أخيرا كما هو متوقع
إضافةً إلى ذلك، ملاحظة هامة: في هذا المثال لحساب المعامل (p في هذا المثال) قمنا بإتباع طريقة تقدير الاحتمال Maximum likelihood و هذا لتوفر كل المعطيات، القطعة النقدية المستعملة في التجربة معلومة (في هذه التجربة استعملنا قطعة نقدية واحدة فلا داعي لتطبيق الخوارزمية EM). ولكن إذا استعملنا قطعتين نقديين لإجراء التجربة، يصبح تقدير المعاملات مستحيلا باعتبار أن القطعة النقدية المستعملة في كل رمية غير معلومة (قد تم اختيار قطعة نقدية في كل رمية عشوائيا). هنا تتدخل الخوارزمية EM لتقدير هذه المعاملات.
وفي السياق ذاته، القارئ بإمكانه التحقق أنه يمثل أقصى نتيجة بفحصه أن المشتقة الثانية تكون سالبة.
خطوة تقدير E
وفي هذا الصدد، تعمل مصفاة كالمان (Kalman) أو المنعم ذو التباين الاصغر المصممان باستعمال مميزات التقديرات الحالية للحصول على تقديرات الوضعية المعدلة.
برهان على صحة EM
من اجل أي باحتمال مختلف عن الصفر , نستطيع ان نكتب
وفي السياق ذاته، EM يعمل على تحسين بدلا من التحسين المباشر لـ: . هنا نقوم باظهار ان تحسين هاته الاخيرة يؤدي إلى تحسين الأولى.
- اين معرفة بالمجموع السلبي الذي تعوضه.
- هذه المعادلة الاخيرة صحيحة لاي قيمة لـ إضافة إلى ,
- وطرح هذه المعادلة الاخيرة من المعادلة السابقة يعطينا
- بالرغم من ذلك, Gibbs' inequality تثبت انه , و بذلك نستطيع ان نستنتج انه
- في الحقيقة اختيار لتحسين باستعمال سيحسن باستعمال .
- بدائل لخوارزمية EM
وفي السياق ذاته، ناخذ التقدير على القيم بضرب جميع الاطراف بـ و الجمع حول . الطرف الايسر هو تقدير لثابت و بالتالي نحصل على:
تطبيقات
ومن جهة أخرى، مع القدرة على التعامل مع البيانات المفقودة ومراقبة المتغيرات المجهولة الهوية، EM أصبح أداة مفيدة لقياس وإدارة المخاطر.
ومن جهة أخرى، في القياس النفسي، لا غنى عن EM لتقدير مميزات الشيء والخصائص الكامنة في نماذج استجابة الاشياء النظرية .
علاوةً على ذلك، كثيرا ما يستعمل EM لتقسيم البيانات في تعلم الآلة و رؤية الكمبيوتر .حيث نجد في معالجة اللغة الطبيعية، نوعين من الخوارزمية هما: خوارزمية باوم-ولش (Baum-Welch algorithm) و خوارزمية الداخل-الخارج (inside-outside algorithm) من اجل التحريض الغير خاضع للرقابة في قواعد النحو الاحتمالية الخالية من السياق.
خطوة تعظيم M
كذلك، قم باستخدام تقديرات الوضعية المنعمة أو المصفاة داخل حسابات الاحتمال الأكبر للحصول على تقديرات المميزات المعدلة.
ومن جهة أخرى، لنفترض أن مصفاة كالمان ( Kalman) أو المنعم ذو التباين الاصغر يعملان على قياسات مشوشة من نظام وحيد الإدخال و الاخراج. فيمكن الحصول على قياس تقدير تباين التشويش من خلال حساب الاحتمال الأكبر كمايلي:
- حيث تمثل تقديرات البيانات الناتجة التي تم حسابها باستخدام المصفاة أو المنعم
- بالمثل يمكن قياس تقدير تباين التشويش كما يلي:
- حيث و تمثل تقديرات الوضعية التي تم حسابها باستخدام المصفاة أو المنعم.
- كمانستطيع قياس تقدير معامل النموذج المعدل كما يلي:
- .
- إلى جانب هذا فان تقارب تقديرات المميزات تم دراسته و اثباته.
التقارب
من جهة ثانية، (الغير) الخصائص الدقيقة لتقارب الخوارزمية متعلقة بمستوى جد عالي و بالتالي لن نناقشها هنا. لكن ببساطة يجب أن نذكر أن في بعض الحالات، الخوارزمية يمكن أن تتقارب إلى نقطة واحدة أو إلى أقصى قيمة محلية للاحتمال (في حالة ما كانت هذه النقطة موجودة). و هذا راجع إلى الاعتماد القوي على الشرط الأولي المختار عشوائيا لانطلاق الخوارزمية.
وفي هذا السياق، لبعض القيم الأولية السيئة لـ , الخوارزمية يمكن أن تبقى ثابتة في نقطة واحدة. بينما تتقارب إلى أقصى قيمة عامة لبعض القيم الملائمة للشرط الأولي. الخوارزمية إذا تتطلب أحيانا تغيير قيم الشرط الأولي عدة مرات.
فلسفة الخوارزمية EM
ومن جهة أخرى، لو أن المعطيات المتاحة وحدها لا تسمح لتقدير المعامل، أو/و أن مصطلح الاحتمال تحليليا مستحيلة التعظيم، الخوارزمية EM تستطيع أن تكون الحل. بشكل عام، إنها تهدف إلى توفير تقدير لو أن هذه الاستحالة تكون في حالة المعطيات غير معلومة أو مخفية. أو بالأحرى، عند معرفة المعطيات يصبح تقدير المعامل ممكن.
كذلك، الجانب التكراري للخوارزمية يستطيع أن يكون غامض، لكن كما سنلاحظ أن الخوارزمية تضمن أن الاحتمال يزداد كل تكرار و هذا يسوق إلى تقديرات أصح.
من جانب آخر، ملاحظة: في التكرار الأول نقوم باختيار المعاملات عشوائيا. مثلا في المثال أعلاه، المعامل p يختار عشوائيا. ثم نقدر الاحتمال أن تكون المعطيات الملحوظة (عدد مرات الحصول على خلف) هي نتيجة رمي القطعة النقدية رقم "1" أو "2" (هذا هو تقدير المعطيات المخفية).
وفي هذا السياق، باختصار، الخوارزمية EM تعمل وفق تقنية طبيعية جدا: إن وجدت عقبة لتطبيق طريقة تعظيم الاحتمال، نقوم ببساطة بتخطي هذه العقبة ثم نطبق هذه الطريقة EM.
وفي هذا السياق، الخوارزمية تستنبط اسمها نتيجة أنها في كل تكرار تمر بمرحلتين متميزين:
من جهة ثانية، الخوارزمية EM, هي خوارزمية تكرارية بالنسبة إلى (Dempster, Laird et Rubin (1977. أنها أسلوب لتقدير المعامل المسجل في إطار عام لأعلى احتمال.
كذلك، مرحلة التوقع: غالبا مسماة بالمرحلة E, تعمل كاسمها افتراضا لتقدير المعطيات الغير معلومة أو المخفية، باعتبار أن المعطيات الملحوظة و المعاملات من المرحلة السابقة معلومة.
إضافةً إلى ذلك، مرحلة التعظيم: أوالمرحلة M ,تعمل على تعظيم وتكبير الاحتمال، تجعله متصاعدا. وهذا ممكن باستعمال التقدير للمعطيات الغير معلومة المحسوبة في المرحلة السابقة، و تحديث المعامل أو المعاملات لتستعمل في التكرار القادم (بالتحديد في المرحلة E القادمة).
المبدأ
كذلك، وهذا يسهل كثيرا الحسابات، ببساطة للعمل بالجمع عوضا عن الضرب.
من جهة ثانية، هي إذا، من العينة الثابتة، قيمة المعامل التي تجعل كل ما أمكن الملاحظات المتحصل عليها متماثلة.
من جانب آخر، و لأسباب تحليلية ملائمة، نفضل غالبا حساب اللوغاريتم بدلا عن حساب ، لأن الدالة اللوغاريتمية هي دائما متزايدة، وهذا يضمن الحصول على نفس قيمة التي تعظم الاحتمال:
- نضع n ملاحظات، يعتبر كانه انجاز n متغير عشوائي مستقل، مطابق و موزع .
- في إطار نموذج إحصائي محدود ξ . كل يتبع نظرية متعلقة بالمعامل .
- مثلا تستطيع ان تكون دالة غاوسية :(N(µ, σ2 و بالتالي (µ, σ2) .
- نعني بـ: أو كثافة .
- نسمي احتمالية العينة، الكثافة المرتبطة لـ: :
- في الحالة الخاصة، في حالة أعداد متقطعة، هذا يعطينا:
- تعريف : التقدير بالمعنى الاقصى لـ هو:
العلاقة مع أساليب بايز التغييرية
كذلك، في الواقع الاستدلال في النهج النظرية الافتراضية هو ببساطة علاج θ كمتغير كامن آخر، في هذا النموذج التمييز بين الخطوة E والخطوة M يختفي.حيث انه إذا استعملنا تقدير Q كما هو موضح أعلاه ( بايز التغييري )، نستطيع تعديل المتغيرات الكامنة (بما في ذلك θ ) في وقت واحدويتبقى سوى تكرار الخطوات.
وفي هذا السياق، EM هو جزئيا اسلوب غير بايزي، حيث يعطي في النتيجة النهائية التوزيع الاحتمالي على المتغيرات الكامنة جنبا إلى جنب مع تقدير θ (إما تقدير الاحتمال الأكبر أو الوضعية المستقبلية). ونحن قد نرغب في نسخة بايزية بشكل كامل حيث تقدم لنا التوزيع الاحتمالي على θ فضلا عن المتغيرات الكامنة.
خوارزمية α-EM
ومن ناحية أخرى، تستند وظيفة Q المستعملة في الخوارزمية EM على لوغاريثم الاحتمال. وبالتالي، فإنها تعتبر خوارزمية لوغاريثم EM.من جهة أخرى فان استخدام لوغاريثم الاحتمال يمكن تعميمه على نسبة لوغاريثم الاحتمال α، و بذلك يمكن التعبير تماما على نسبة لوغاريثم الاحتمال α من البيانات باستخدام Q بالحصول على Q بخطوة تقدير E و تعظيمها بخطوة تعظيم M. وبالتالي، فإن خوارزمية α-EM التي كتبها ياسو ماتسوياما (Yasuo Matsuyama) هو التعميم الدقيق لخوارزمية لوغاريثم EM ،حيث ليس هناك حاجة إلى حساب مصفوفة متدرجة. علاوةً على ذلك α-EM تتقارب بطريقة أسرع من خوارزمية لوغاريثم EM باختيار α المناسب.
مثال
علاوةً على ذلك، وبديهيا ناخد قيمة p بحساب تردد عدد المرات خلف، بالتالي . وهذا يمثل أعلى تقدير لـ p .
- للتأكد من هذه الفرضية حسابيا، نتبع الخطوات التالية:
- احتمال X هو:
- و هذا يعني أن احتماله اللوغاريتمي هو:
- نبحث لتحقيق أكبر قدر للاحتمال اللوغاريتمي: أقصاه يجب ان يلغي مشتقته و نحلها بـ:
علاوةً على ذلك، نعتبر 30 رمية انها إنجازات غير مرتبطة ببعضها و تتبع قانون الاحتمال ذو خاصية برنولي (β(p ذو المعامل المجهول p, الذي يإخذ القيمة 1 إذا حصلنا على خلف و 0 إذا حصلنا على وجه. كذلك عدد المرات التي حصلنا فيها على خلف بإتباع القانون (β(p,30 .
علاوةً على ذلك، تقدير المعامل لقانون الاحتمال ذو خاصية برنولي (توزيع ثنائي الحدين)، نرمي قطعة نقدية التي يحتمل أن تكون مزورة لـ 30 رمية، نعتبر أنتا حصلنا على 22 مرة خلف و 8 مرات وجه.
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟