تعرف المحارف البصري
المحتويات
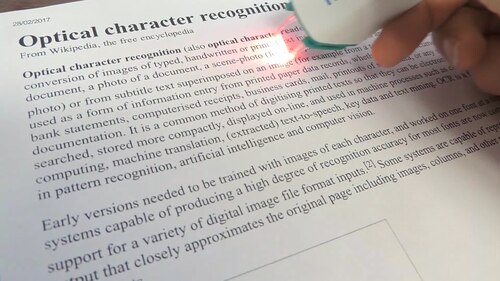
تعريفًا بالموضوع، تعرُّف المحارف البصري قد يسمى كذلك تعرف المحارف المرئي أو اختصارا OCR هي نوع من البرمجيات الحاسوبية لتحويل صور النصوص المكتوبة باليد أو بآلة (يحصل عليها عادة باستخدام الماسحة) إلى نصوص يستطيع الحاسوب معالجتها. هو آلية أو تحويل الصورة الممسوحة الالكترونية من صيغة مكتوبة بخط اليد، أو مطبوعة على الآلة الكاتبة أو نص مطبوع إلى نص مرمز تفهمه الآلة وتدعى
ومن ناحية أخرى، لإنه من الأهمية بمكان أن حوسبة النصوص المطبوعة تكون مطلبا حتى يمكن أن يكون البحث عنها أوتخزينها إلكترونيا بحيث تصبح قابلة للانضغاط أكثر ليتيسر عرضها على الإنترنت، وتستعمل في عمليات آلية مثل الترجمة الآلية، تحويل النص إلى كلام والغوص في النصوص. التعرف البصري على الحروف هو مجال البحث في التعرف على النماذج، الذكاء الاصطناعي وجهاز الرؤية عن طريق الحاسوب.
علاوةً على ذلك، آلة ترميز النصوص. ويستعمل على نطاق واسع باعتباره شكلا من أشكال إدخال البيانات من نوع ما من ورقة البيانات المصدر الأصلي، سواء وثائق، أوايصالات مبيعات، والبريد، أو أي عدد من السجلات المطبوعة.
علاوةً على ذلك، هناك حاجة لإصدارات في وقت مبكر حتى يتسنى أن تبرمج الصور تبعا لكل حرف، وتعمل على خط واحد في وقت واحد. النظام «الذكي» مع وجود درجة عالية من دقة التعرف على أغلب الخطوط أصبحت شائعة الآن. بعض الأنظمة الآن قادرة على إنتاج حروف تمت تهيئتها formatted output وهي تقترب كثيرا من الشكل الأصلي بما في ذلك الصور الممسوحة بصريا، والأعمدة وغيرها من العناصر غير النصية.
برمجيات التعرف الضوئى على الحروف
وفي السياق ذاته، برامج التعرف البصري على الحروف وبرمجيات ICR التكنولوجيا هي أنظمة الذكاء الاصطناعي للتحليلات التي تنظر في تسلسل الحروف بدلا من الكلمات أو العبارات كلها. استنادا إلى تحليلات للخطوط والمنحنيات المتتابعة، للتعرف البصري على الحروف حيث OCR و ICR تفعل أفضل التخمينات على الحروف باستخدام قاعدة بيانات للمتابعة عن كثب لربط الجداول أو تتطابق مع سلاسل الحروف التي تكون الكلمات.
- WebOCR & OnlineOCR
- التعرف البصري على الحروف على شبكة الإنترنت
- التقنيات
برامج التعرف البصري على الحروف لسطح المكتب والخوادم
المعالجة المسبقة
وفي هذا السياق، التثنية (Binarization): تحويل الصورة من ملونة أو ذات تدرج رمادي إلى صورة بالأبيض والأسود (تُعرف بالصورة الثنائية نظرًا لوجود لونين فقط). تُنفذ هذه العملية كطريقة مبسطة لفصل النص (أو أي عنصر مرغوب آخر في الصورة) عن الخلفية. تُعد مهمة التثنية ضرورية لأن أغلب الخوارزميات التجارية للتعرف الضوئي على الحروف تعمل بكفاءة أكبر على الصور الثنائية. علاوةً على ذلك، تؤثر جودة عملية التثنية بدرجة كبيرة على دقة التعرف على الأحرف، ويتطلب اختيار تقنية التثنية المناسبة لنوع معين من صور الإدخال دراية دقيقة؛ حيث تعتمد جودة النتيجة الثنائية على طبيعة الصورة الأصلية (مستند ممسوح ضوئيًا، صورة نصية في مشهد طبيعي، مستند تاريخي تالف، إلخ).
ومن جهة أخرى، تحليل التخطيط أو تقسيم المناطق (Layout analysis or zoning): تحديد الأعمدة والفقرات والعناوين التوضيحية وغيرها ككتل نصية منفصلة. يُعد هذا الإجراء بالغ الأهمية في المستندات ذات التخطيطات متعددة الأعمدة والجداول.
من جهة ثانية، إزالة الانحراف (Deskewing): في حال لم يكن المستند محاذيًا بشكل صحيح عند المسح الضوئي، قد يلزم إمالته بزاوية طفيفة في اتجاه عقارب الساعة أو عكسه لجعل أسطر النص أفقية أو رأسية تمامًا.
ومن ناحية أخرى، التعرف على النصوص (Script recognition): في المستندات متعددة اللغات، قد يختلف النص على مستوى الكلمات، وبالتالي، يكون تحديد لغة النص ضروريًا قبل استدعاء محرك التعرف الضوئي على الحروف المناسب للتعامل مع النص المحدد.
وعلى صعيد آخر، تُعالج الخطوط ذات المسافات الثابتة بسهولة نسبية عن طريق محاذاة الصورة على شبكة موحدة، بناءً على المناطق التي تتقاطع فيها الخطوط الرأسية للشبكة مع المناطق السوداء بتكرار أقل. أما بالنسبة للخطوط ذات المسافات المتغيرة، فإنها تتطلب تقنيات أكثر تعقيدًا، نظرًا لأن المسافة بين الأحرف قد تكون أكبر أحيانًا من المسافة بين الكلمات، وقد تتقاطع الخطوط الرأسية مع أكثر من حرف واحد.
كذلك، عزل الأحرف أو تقسيمها (Character isolation or segmentation): بالنسبة لتقنيات التعرف الضوئي على الحروف التي تعمل على مستوى الحرف، يجب فصل الأحرف المتصلة ببعضها البعض نتيجة لتشوهات الصورة؛ وبالمقابل، يجب ربط الأجزاء المنفصلة من حرف واحد بسبب تشوهات مماثلة.
وفي هذا السياق، اكتشاف الخطوط والكلمات (Line and word detection): إنشاء خط أساس لأشكال الكلمات والأحرف، وفصل الكلمات عند الضرورة.
من جانب آخر، تطبيع نسبة العرض إلى الارتفاع والمقياس (Normalization of aspect ratio and scale).
ومن جهة أخرى، إزالة البقع (Noise removal): التخلص من النقاط والتشويشات الإيجابية والسلبية وتنعيم حواف الأحرف.
ومن ناحية أخرى، إزالة الخطوط (Line removal): تنظيف وإزالة المربعات والخطوط غير النصية.
في هذا الإطار، غالبًا ما تُجري برامج التعرف الضوئي على الحروف (OCR) عمليات معالجة مسبقة للصور بهدف تحسين فرص التعرف الناجح عليها. تتضمن هذه التقنيات ما يلي: [15]
فرض إدخال أفضل
في هذا الإطار، أما حقول المشط فهي عبارة عن مربعات تُطبع مسبقًا على المستندات لتشجيع المستعملين على الكتابة بوضوح أكبر، وذلك بتخصيص مربع واحد لكل رمز. وغالبًا ما تُطبع هذه الحقول بلون متقطع يسهل على أنظمة التعرف الضوئي على الحروف إزالته.
وفي هذا السياق، أخيرًا، التعرف الضوئي على الحروف القائم على المنطقة يقتصر على تحليل جزء محدد من الصورة في المستند. ويُشار إلى هذا الأسلوب غالبًا باسم التعرف الضوئي على الحروف للقالب.
وفي السياق ذاته، من جهة أخرى، استعمل نظام التشغيل Palm OS مجموعة فريدة من الرموز الكتابية، عُرفت باسم Graffiti، والتي كانت تشبه الحروف الإنجليزية المطبوعة ولكنها مبسطة أو معدلة لتسهيل عملية التعرف عليها على الأجهزة ذات القدرات الحاسوبية المحدودة. وكان يتعين على المستعملين تعلم طريقة كتابة هذه الرموز الخاصة.
وفي السياق ذاته، تساهم الخطوط الخاصة، مثل OCR-A، وOCR-B، وMICR، والتي تتميز بأبعاد ومسافات وأشكال حروف دقيقة ومحددة، في تحقيق دقة أعلى أثناء عملية النسخ في تطبيقات مثل معالجة الشيكات المصرفية. في حين أن الكثير من محركات التعرف الضوئي على الحروف (OCR) المعروفة مُصممة للتعامل مع الخطوط الشائعة كالخطوط Arial وTimes New Roman، فإنها قد لا تكون قادرة على التعرف على هذه الخطوط المتخصصة والمختلفة إلى حدّ كبير عن الخطوط القياسية. ومع ذلك، نظرًا لقدرة برنامج Google Tesseract على التدرب على التعرف على خطوط جديدة، فإنه يستطيع التعامل مع خطوط OCR-A، وOCR-B، وMICR.
أنواع
وفي السياق ذاته، التعرف الضوئي على الحروف (OCR): يركز على تحليل النصوص المكتوبة، وذلك بمعالجة كل حرف أو رمز على حدة.
وفي السياق ذاته، التعرف الذكي على الكلمات (IWR): يركز على تحليل النصوص المطبوعة أو المكتوبة بخط اليد، وذلك بمعالجة الكلمات كوحدات منفصلة. ويُعد هذا النوع ذا أهمية خاصة للغات التي لا تفصل فيها الوحدات الكتابية بشكل واضح في النص المتصل.
إضافةً إلى ذلك، في مجال التعرف على النصوص، تتعدد أنواع التقنيات المستعملة، وتشمل:
كذلك، التعرف الضوئي على الكلمات: يختص بالنصوص المطبوعة، حيث يتم تحليل الكلمات كوحدات منفصلة (وهو الأسلوب الأمثل للغات التي تعتمد على المسافات لفصل الكلمات). ويُشار إليه غالبًا كذلك بمصطلح "التعرف الضوئي على الحروف".
في هذا الإطار، التعرف الذكي على الحروف (ICR): يهدف إلى تحليل النصوص المطبوعة أو المكتوبة بخط اليد، وذلك بمعالجة كل حرف أو رمز على حدة، وعادةً ما يستفيد من تقنيات التعلم الآلي لتحسين الدقة.
علاوةً على ذلك، جدير بالذكر أن التعرف الضوئي على الحروف (OCR) يمثل عملية تحليل غير مباشرة (offline)، حيث يتم فحص المستند الثابت. وفي المقابل، تتوفر خدمات سحابية تقدم واجهات برمجة تطبيقات (API) لتنفيذ عمليات التعرف الضوئي على الحروف بشكل مباشر (online).
ومن ناحية أخرى، علاوة على ذلك، يمكن الاستعانة بتقنية تحليل حركة الكتابة اليدوية كمدخل لتعزيز دقة التعرف على النصوص المكتوبة بخط اليد. [14] فبدلًا من الاقتصار على شكل الحروف والكلمات، تقوم هذه التقنية بتسجيل وتحليل حركة القلم أثناء الكتابة، مثل ترتيب رسم المقاطع، والاتجاه، ونمط الضغط على القلم ورفعه. هذه المعلومات الإضافية تسهم في تحقيق دقة أعلى في التعرف. وتُعرف هذه التقنية كذلك بمسميات أخرى مثل "التعرف على الحروف المباشر" (online character recognition)، و"التعرف الديناميكي على الحروف" (dynamic character recognition)، و"التعرف الفوري على الحروف" (real-time character recognition)، و"التعرف الذكي على الحروف" (intelligent character recognition).
يونيكود
كذلك، بعض هذه الأحرف مُستقاة من خطوط خاصة بتقنية MICR، أو OCR-A، أو OCR-B.
التقنيات
ومن ناحية أخرى، أُضيفت الأحرف الداعمة لتقنية التعرف الضوئي على الحروف (OCR) إلى معيار Unicode في يونيو 1993، مع إصدار الإصدار 1.1.
دقة
كذلك، ومن الأمثلة على التحديات الكامنة في رقمنة النصوص القديمة عدم قدرة التعرف الضوئي على الحروف على التمييز بين حرفي "s" الطويل ("ſ") وحرف "f" .
وفي هذا السياق، تتيح أغلب البرامج للمستعملين تحديد "معدلات الثقة". وهذا يعني أنه في حال لم يحقق البرنامج مستوى الدقة المطلوب، يمكن إخطار المستعمل لإجراء مراجعة يدوية.
وفي السياق ذاته، بتكليف من وزارة الطاقة الأمريكية (DOE)، اضطلع معهد أبحاث علوم المعلومات (ISRI) بمهمة تعزيز تطوير التقنيات الآلية لفهم المستندات المطبوعة آليًا. وفي هذا الإطار، أجرى المعهد الاختبار السنوي الأكثر مصداقية لدقة التعرف الضوئي على الحروف في الفترة من عام 1992 إلى عام 1996.
ومن جهة أخرى، يُطلق أحيانًا على الخطأ الناتج عن عملية مسح التعرف الضوئي على الحروف اسم "خطأ في المسح الضوئي" (scan error)، قياسًا على مصطلح "الخطأ المطبعي" (typo).
وفي هذا الصدد، يُعد التعرف على النصوص المكتوبة بخط اليد مجالًا بحثيًا نشطًا، حيث تكون معدلات التعرف عليه أقل حتى من معدلات التعرف على النصوص المطبوعة يدويًا. ومن غير المرجح تحقيق معدلات أعلى للتعرف على النصوص المكتوبة بخط اليد دون استخدام معلومات سياقية أو نحوية. مثلًا، يُعد التعرف على الكلمات الكاملة من القاموس أسهل من محاولة تحليل أحرفها الفردية. وتُعد قراءة سطر المبلغ في الشيك (وهو دائمًا رقم مكتوب) مثالًا على كيفية زيادة معدلات التعرف إلى حدّ كبير باستخدام قاموس أصغر حجمًا. ببساطة، لا تحتوي أشكال الأحرف المكتوبة بخط اليد على معلومات كافية لتحقيق دقة عالية (تزيد عن 98%) في التعرف على جميع النصوص المكتوبة بخط اليد. [بحاجة لمصدر]
إضافةً إلى ذلك، لا يزال التعرف على النصوص المكتوبة بالخط اللاتيني غير دقيق بنسبة 100% حتى في ظل توفر صور واضحة. وقد خلصت دراسة استندت إلى تحليل صفحات الصحف من القرنين التاسع عشر والعشرين إلى أن دقة التعرف الضوئي على الحروف (OCR) على مستوى الحرف الواحد لبرامج التعرف الضوئي على الحروف التجارية تتراوح بين 81% و99%. ويمكن تحقيق دقة كاملة من خلال المراجعة البشرية أو التحقق من البيانات باستخدام القواميس. ولا تزال مجالات أخرى، تشمل التعرف على الطباعة اليدوية، والكتابة اليدوية المتصلة، والنصوص المطبوعة بلغات أخرى (خاصةً أحرف لغات شرق آسيا التي تتضمن الكثير من الخطوط لكل حرف)، موضوعًا نشطًا للبحث. وتُستعمل قاعدة بيانات MNIST بشكل شائع لاختبار قدرة الأنظمة على التعرف على الأرقام المكتوبة بخط اليد.
كذلك، يمكن قياس معدلات الدقة بطرق متنوعة، وتؤثر طريقة القياس بدرجة كبيرة على معدل الدقة المعلن عنه. مثلًا، إذا لم يُستعمل سياق الكلمة (معجم الكلمات) لتصحيح الأخطاء في البرامج التي تجد كلمات غير موجودة، فقد يؤدي معدل خطأ في الأحرف بنسبة 1% (دقة 99%) إلى معدل خطأ بنسبة 5% أو أسوأ إذا كان القياس يعتمد على ما إذا تم التعرف على كل كلمة كاملة دون أي أحرف غير صحيحة. ويُعد استخدام مجموعة بيانات كبيرة بما يكفي أمرًا بالغ الأهمية في حلول التعرف على الكتابة اليدوية القائمة على الشبكات العصبية. ومن ناحية أخرى، فإن إنشاء مجموعات بيانات واقعية يُعد عملية معقدة للغاية وتستغرق وقتًا طويلًا.
من جانب آخر، شهدت أنظمة التعرف الضوئي على الحروف (OCR) القائمة على الويب، والتي تُستعمل للتعرف الفوري على النصوص المطبوعة يدويًا، انتشارًا تجاريًا واسعًا في السنوات الأخيرة [متى؟] (راجع تاريخ أجهزة الكمبيوتر اللوحية). يمكن تحقيق معدلات دقة تتراوح بين 80% و90% على الأحرف المطبوعة يدويًا بشكل أنيق ونظيف باستخدام برامج الحوسبة بالقلم، إلا أن هذا المستوى من الدقة لا يزال يؤدي إلى ظهور عشرات الأخطاء في كل صفحة، مما يجعل هذه التقنية مفيدة فقط في تطبيقات محدودة للغاية. [بحاجة لمصدر]
الحلول البديلة
علاوةً على ذلك، بالتأكيد، إلى جانب تطوير خوارزميات التعرف الضوئي على الحروف (OCR) وتحسينها، توجد تقنيات أخرى تُستعمل لمعالجة تحديات التعرف على الحروف والنصوص. هل تود أن نتناول بعضًا من هذه التقنيات البديلة؟
التاريخ
إضافةً إلى ذلك، في سنة 1929 غوستاف تاوشك Tauschek كان لديه أفكار مماثلة، وحصل على براءة اختراع في التعرف البصري على الحروف في ألمانيا. بول جورج هاندل كذلك حصل على براءة أميريكية في قالب تكنولوجيا مطابقة التعرف البصري على الحروف في الولايات المتحدة الأمريكية في عام 1933 .في سنة 1935 حصل كذلك Tauschek على براءة اختراع في الولايات المتحدة على طريقته .
في هذا الإطار، وكان في عام 1955، قد تم تركيب أول نظام تجاري في مجلة ريدرز دايجست ، والتي تستعمل التعرف البصري على الحروف لإرسال تقارير المبيعات إلى جهاز الكمبيوتر. حيث قامت بتحويل التقارير المطبوعة إلى بطاقات المثقبة لإدخالها في الكمبيوتر في قسم الاشتراكات في المجلة، للمساعدة في تجهيز شحنات من 15-20 مليون كتاب في السنة
وربط القارئ مباشرة إلى كمبيوتر آر سى أ 301 وهو واحد من
ومن ناحية أخرى، . تم بيع النظام الثاني إلى شركة ستاندرد أويل لقراءة بصمات بطاقات الائتمان لأغراض الفوترة. وشملت غيرها من النظم التي تبيعها IMR خلال أواخر 1950 قارئ كعوب الفواتير مشروع القانون إلى شركة أوهايو بيل للتليفونات وماسح بصري للصفحات إلى للقوات الجوية للولايات المتحدة لقراءة وإرسال الرسائل المبرقة بواسطة الآلة الكاتبة. واجيزت آي بي إم وآخرون في وقت لاحق للحصول على براءات الاختراع شيبرد للتعرف البصري على الحروف.
وعلى صعيد آخر، و في سنة 1950 ديفيد شيبرد وهو cryptanalyst في وكالة الأمن بالقوات المسلحة في الولايات المتحدة، معالجة مشكلة تحويل الرسائل المطبوعة إلى لغة الآلة لل تجهيز الكمبيوتر، وبناء جهاز للقيام بذلك، ودعيت جزمو Gismo .". حصل على براءة اختراع لتطويره "جهاز القراءة" في عام 1953. “
كذلك، واصل جولدبرغ تطوير تكنولوجيا التعرف البصري على الحروف لإدخال البيانات. وفيمابعد اقترح تصوير سجلات البيانات ومن ثم، وذلك باستخدام الخلايا البصرية، مطابقة الصور ضد قالب يحتوي على نمط محدد وهو النمط المطلوب.
وفي هذا الصدد، جزمو يمكنه "قراءة 23 حرفا من الحروف الأبجدية الإنجليزية، ويقوم بترجمة إشارات مورس، ويقرأ الرموز الموسيقية، ويقرأ بصوت مسموع من صفحات مطبوعة ويقوم بتكرارا صفحات مطبوعة. شيبرد ذهب إلى العثور على مؤسسة البحوث للآلات الذكية (IMR)، والتي سرعان ما وضعت أول أنظمة تجارية للتعرف البصري على الحروف في العالم.
من جانب آخر، وفي سنة 1949 فإن مهندسوشركة راديو أمريكا عملوا على التعرف البصري على الحروف بنوع بدائى أولى بمساعدة الكمبيوتر لمساعدة المكفوفين ولإدارة شؤون المحاربين القدامى في الولايات المتحدة، ولكن بدلا من تحويل الأحرف المطبوعة إلى لغة الآلة، تم تحويلها من جهاز إلى جهاز اللغة المتكلمة ومن ثم الحروف: في وقت مبكر دفعا إلى تكنولوجيا النص إلى كلام.حيث ثبت حتى الآن أنها مكلفة للغاية، ولم يكن السعي إلى الإسستمرار فيها بعد اختبارها.
من جهة ثانية، ويمكن أن يعزى التعرف البصري على الحروف في وقت مبكر للنشاط حول مسألتين: توسيع الإبراق وخلق أجهزة القراءة للمكفوفين. في سنة 1914 ايمانويل جولدبرغ صنع آلة لقراءة الأحرف وتحويلها إلى رموز التلغراف القياسية. في نفس الوقت على وجه التقريب، إدموند فورنييه ديفوار d'Albe طور Optophone ، ماسح بصري محمول حيث يتم تحريكه عبر الصفحة المطبوعة، فيقوم بإنتاج نغمات التي تتوافق مع أشكال محددة أو حروفا.
علاوةً على ذلك، في نحو 1965، تعاونت مجلة ريدرز دايجست مع RCA لبناء قارئ تعرف ضوئى للحروف، مصمم إلى رقمنة الأرقام التسلسلية وتقييم النتائج والكفاءات على كوبونات مجلة ريدرز دايجست العائدة من الإعلانات. وطبعت الخطوط المستعملة في وثائق بواسطة طابعة الطبل RCA باستخدام OCR-Aالخط.
إضافةً إلى ذلك، أجهزة الكمبيوتر الحالة الصلبة 1).وأعقب هذا توصيله من قبل قارئ وثائق متخصص ركب إلى TWA حيث القارئ يعالج مخزون تذاكر شركة طيران. القارئ يعالج الوثائق بمعدل 1500 وثيقة في الدقيقة، ويفحص كل وثيقة، ويرفض تلك التي لاتقبل المعالجة بطريقة صحيحة وأصبح هذا المنتج جزءا من خط إنتاج RCA كقارئ مصمم لمعالجة «الوثائق الدوارة» مثل تلك التي تشمل فواتير المياه والكهرباء والتأمين وعائدات المدفوعات.
اللغة العربية
وفي هذا السياق، التعرف البصري على المحارف العربية Optical Character Recogniation for Arabic Language : يعتبر من أهم المواضيع البحثية فيما يتصل بتطوير استخدام اللغة العربية. الأحرف العربية تحوي على 28 حرفاً وهذه الأحرف تأخذ صيغ شكلية مختلفة اعتماداً على توضعها في أول الكلمة أو وسطها أو في نهايتها. التعرف البصري على المحارف العربية قد يكون آني أي يتم التعرف خلال زمن الكتابة Online أو من خلال معالجة وثائق تحوي على نص مكتوب باللغة العربية Offline
- انظر كذلك
- لغويات حاسوبية
- رؤية حاسوبية
- مكتبة رقمية
- قلم رقمي
- تعلم الآلة
- ريموند كرزويل
- تعرف الكلام
- تسجيل الصوت وإعادة إنتاجه
قبل التجهيز
علاوةً على ذلك، برمجيات التعرف البصري على الحروف في كثير من الأحيان هي صور «عمليات ما قبل» لتحسين تقنيات فرص تعرف ناجحة.وتشمل ما يلي:
إضافةً إلى ذلك، دي تحرف متباعدة إذا لم يتم محاذاة المستند ليكون متوائما بشكل صحيح عند فحصهه، قد تحتاج إلى أن تميل بضع درجات في اتجاه عقارب الساعة أو عكس اتجاه عقارب الساعة من أجل جعل أسطر من النص أفقية تماما أو عمودية.
التعرف على النص
إضافةً إلى ذلك، مطابقة المصفوفات (Matrix matching): تتضمن هذه التقنية مقارنة صورة الحرف أو الرمز المدخل برمز مُخزن مسبقًا بكسلًا بكسلًا. تُعرف كذلك باسم مطابقة الأنماط (pattern matching)، أو التعرف على الأنماط (pattern recognition)، أو ارتباط الصور (image correlation). تعتمد هذه الطريقة على عزل الرمز المدخل بشكل دقيق عن بقية الصورة، وأن يكون الرمز المُخزن مكتوبًا بخط مشابه وبنفس الحجم. تحقق هذه التقنية أفضل النتائج مع النصوص المطبوعة، ولكنها تكون أقل فعالية مع الخطوط الجديدة أو غير المألوفة. كانت هذه التقنية من أوائل التقنيات التي طُبقت في أنظمة التعرف الضوئي على الحروف (OCR) القائمة على الخلايا الضوئية المادية، ولكن بطريقة مباشرة.
التطبيقات
وفي هذا الصدد، جعل المستندات الممسوحة ضوئيًا قابلة للبحث: عن طريق تحويلها إلى ملفات PDF.
ومن جهة أخرى، محاولة تجاوز أو اختبار قوة أنظمة التحقق البشري CAPTCHA: على الرغم من أن هذه الأنظمة مصممة خصيصًا لمنع التعرف الضوئي على الحروف.
وفي السياق ذاته، يمكن استخدام هذه البرامج في مجموعة واسعة من التطبيقات، منها:
- التعرف التلقائي على لوحات أرقام المركبات.
- التعرف على جوازات السفر واستخراج المعلومات في المطارات.
- الاستخراج التلقائي للمعلومات الرئيسية من مستندات التأمين. [بحاجة لمصدر]
- التعرف على إشارات المرور.
- استخراج معلومات بطاقات العمل إلى قوائم جهات الاتصال.
في هذا الإطار، إدخال البيانات من المستندات التجارية: مثل الشيكات، وجوازات السفر، والفواتير، وكشوف الحسابات المصرفية، والإيصالات.
في هذا الإطار، تحويل الكتابة اليدوية في الوقت الفعلي للتحكم في الحاسوب (الحوسبة بالقلم).
وعلى صعيد آخر، جعل الصور الإلكترونية للمستندات المطبوعة قابلة للبحث: كما هو الحال في مشروع كتب جوجل.
وعلى صعيد آخر، إنشاء نسخ نصية من المستندات المطبوعة: مثلًا، في مشاريع مسح الكتب مثل مشروع غوتنبرغ.
وفي هذا الصدد، كتابة تعليمات خاصة بالمركبات: من خلال تحديد صور التصميم بمساعدة الحاسوب (CAD) في قاعدة البيانات المناسبة لتصميم المركبة وتحديثها في الوقت الفعلي.
وفي السياق ذاته، تطورت محركات التعرف الضوئي على الحروف (Optical Character Recognition - OCR) لتصبح تطبيقات برمجية متخصصة في مجالات متنوعة، مثل معالجة الإيصالات والفواتير والشيكات ومستندات الفواتير القانونية.
توفير تكنولوجيا مساعدة للمستعملين المكفوفين وضعاف البصر.
مرحلة ما بعد المعالجة
وفي هذا الصدد، كما أن الإلمام بقواعد اللغة التي يجري مسحها ضوئيًا يمكن أن يساعد في تحديد الاحتمالية بأن تكون كلمة معينة فعلًا أو اسمًا، مثلًا، مما يسمح بتحقيق دقة أكبر.
كذلك، يمكن لتقنية تحليل الجوار القريب (near neighbor analysis) الاستفادة من معدلات التواجد المشترك (co-occurrence frequencies) للكلمات لتصحيح الأخطاء، وذلك من خلال ملاحظة أن بعض الكلمات تظهر معًا بشكل متكرر. مثلًا، عبارة "Washington, DC" أكثر شيوعًا في اللغة الإنجليزية من "Washington DOC".
ومن جهة أخرى، تعتمد بعض أنظمة التعرف الضوئي على الحروف (OCR) على التعرف القائم على المعجم (lexicon-based recognition)، حيث يُستعمل قاموس للكلمات الشائعة في اللغة الهدف، أو معجم أكثر تخصصًا لمجال معين. قد تظهر تحديات في هذه التقنية إذا احتوى المستند على كلمات غير موجودة في القاموس، مثل الأسماء العلم. يستعمل برنامج Tesseract قاموسه للتأثير على خطوة تقسيم الأحرف، بهدف تحسين الدقة.
كذلك، قد يكون الناتج النهائي مجرد نص عادي أو ملف من الأحرف، ولكن أنظمة التعرف الضوئي على الحروف الأكثر تطورًا قادرة على الحفاظ على التصميم الأصلي للصفحة وإنتاج، مثلًا، ملف PDF يتضمن الصورة الأصلية للصفحة فضلًا عن تمثيل نصي قابل للبحث.
وفي هذا الصدد، فضلًا عن ذلك، استُخدمت خوارزمية مسافة ليفنشتاين (Levenshtein distance algorithm) في عمليات المعالجة اللاحقة لنتائج التعرف الضوئي على الحروف (OCR) بهدف تحسين النتائج الواردة من واجهات برمجة تطبيقات التعرف الضوئي على الحروف بشكل أكبر.
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟