تعلم عميق بالتعزيز
على سبيل التعريف، تعلم عميق بالتعزيز (بالإنكليزية: Deep RL) هو مجال فرعي من التعلم الآلي يجمع بين تعلم بالتعزيز (آر إل) والتعلم العميق. يدرس التعليم بالتعزيز مسألة تعلم الوكيل الحسابي لاتخاذ القرارات عن طريق التجربة والخطأ. يدمج التعليم العميق بالتعزيز التعلم العميق في الحل، ما يسمح للوكلاء باتخاذ قرارات من بيانات مدخلة غير المهيكلة دون هندسة يدوية لفضاء الحالة. تعد خوارزميات التعليم العميق بالتعزيز قادرة على استيعاب مدخلات كبيرة جدًا (يعرض كل بكسل مثلًا على الشاشة في لعبة فيديو) وتحديد الإجراءات التي يجب تنفيذها لتحسين الهدف (تعظيم نتيجة اللعبة). استعمل التعلم العميق بالتعزيز لمجموعة متنوعة من التطبيقات تشمل مثلًا لا الحصر الروبوتات، وألعاب الفيديو، ومعالجة اللغة الطبيعية، والرؤية الحاسوبية، والتعليم، والنقل، والتمويل والرعاية الصحية. وتعرض الأقسام التالية جوانب أخرى من الموضوع.
لمحة عامة
بحث
في هذا الإطار، يعد التعلم العميق بالتعزيز مجالًا نشطًا للبحث، وله عدة خطوط بحثية.
التعلم العميق بالتعزيز
وفي هذا السياق، في الكثير من مسائل اتخاذ القرار العملية، تكون حالات s لقرارات عملية ماركوف عالية الأبعاد (مثل صور من كاميرا أو تيار الاستشعار الأولي من روبوت) ولا يمكن حلها بواسطة خوارزميات التعليم بالتعزيز التقليدية. تتضمن خوارزميات التعلم العميق بالتعزيز التعلم العميق لحل قرارات عملية ماركوف هذه، وغالبًا ما تمثل نهج π(als) أو الوظائف المكتسبة الأخرى كشبكة عصبونية، وتطور خوارزميات متخصصة تعمل جيدًا في هذا الإعداد.
التعلم بالتعزيز
وفي هذا السياق، يعد التعلم بالتعزيز عملية يتعلم فيها الوكيل اتخاذ القرارات عن طريق التجربة والخطأ. تصمم هذه المسألة رياضيًا غالبًا كقرارات عملية ماركوف (إم دي بّي)، حيث يتخذ الوكيل في كل خطوة في حالة s، إجراء a، ويتلقى مكافأة قياسية وينتقل إلى الحالة التالية s` بحسب ديناميكيات البيئة (s`ls,a)Ƥ. يحاول الوكيل تعلم نهج π(als) أو المخطط من الملاحظات إلى الإجراءات، لتعظيم عوائدها (مجموع المكافأت المتوقعة). في التعلم بالتعزيز (على عك التحكم الأمثل)، لا تتمتع الخوارزمية إلا بإمكانية الوصول إلى الديناميكيات (s`ls,a)Ƥ عن طريق أخذ العينات.
استكشاف
كذلك، يجب أن يوازن وكيل التعليم بالتعزيز بين مفاضلة الاستكشاف/الاستخدام: مسألة تحديد ما إذا كان يجب متابعة الإجراءات التي يعرف بالفعل أنها تحقق مكافأت عالية أو استكشاف إجراءات أخرى من أجل اكتشاف مكافأت أعلى. يجمع وكلاء التعليم بالتعزيز عادةً البيانات بنوع من النهج العشوائي، مثل توزيع بولتزمان في مساحات العمل المنفصلة أو التوزيع الغاوسي في مساحات العمل المتصلة، ما يؤدي إلى سلوك استكشاف أساسي. تعد الفكرة وراء الاستكشاف القائم على الحداثة، أو الاستكشاف المدفوع بالفضول، هي إعطاء الوكيل دافعًا لاستكشاف مكافأت غير معروفة من أجل إيجاد أفضل الحلول. يتم ذلك عن طريق «تعديل تابع الخسارة (أو حتى بنية الشبكة) عن طريق إضافة مصطلحات لتحفيز الاستكشاف». يمكن كذلك مساعدة الوكيل في الاستكشاف عن طريق الاستفادة من العروض التوضيحية للمسارات ناجحة، أو تشكيل المكافأت، وإعطاء الوكيل مكافأت وسيطة مخصصة لتناسب المهمة التي يحاول إكمالها.
التعلم العميق
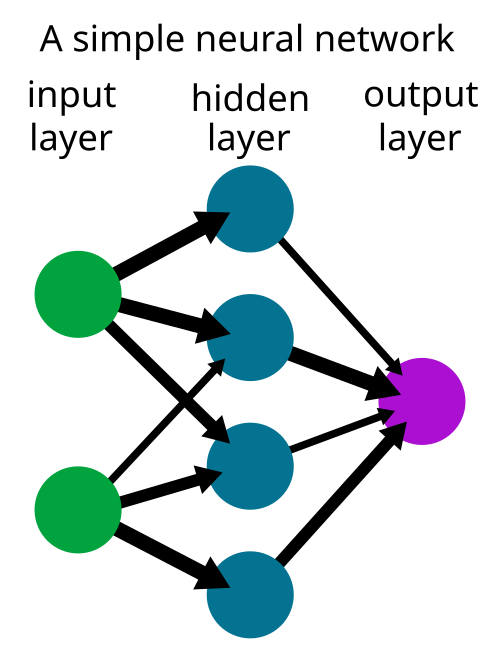
وفي هذا السياق، التعلم العميق هو شكل من أشكال التعلم الآلي يستعمل شبكة عصبونية لتحويل مجموعة مدخلات إلى مجموعة مخرجات عبر شبكة عصبونية اصطناعية. أظهرت طرق التعلم العميق، التي تستعمل غالبًا التعلم بالإشراف مع مجموعات البيانات المصنفة، أنها تحل المهام التي تتضمن التعامل مع بيانات المدخلات الأولية المعقدة وعالية الأبعاد مثل الصور، مع هندسة مقاييس يدوية أقل من الطرق السابقة، ما يتيح تحقيق تقدم كبير في الكثير من المجالات بما في ذلك الرؤية الحاسوبية ومعالجة اللغة الطبيعية.
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟