ستيبل ديفيوجن
المحتويات
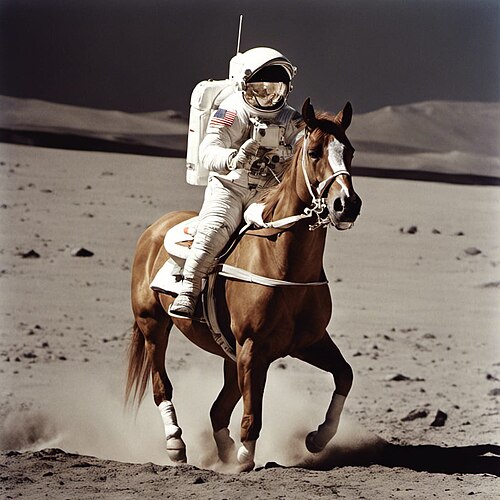
على سبيل التعريف، ستيبل ديفيوجن هو نموذج تعلم عميق لتحويل النص إلى صورة أصدرته شركة ستابيليتي أيه آي في عام 2022 استنادًا إلى تقنيات نموذج ديفيوجن، ويعتبر جزءًا من طفرة الذكاء الاصطناعي المستمرة. ونتناول فيما يلي مزيدًا من التفاصيل.
وعلى صعيد آخر، يُعد ستيبل ديفيوجن نموذج انتشار كامن، وهو نوع من الشبكات العصبية الاصطناعية التوليدية العميقة. تم إصدار شفرته ونموذجه علنًا، ويمكن تشغيله على أغلب أجهزة المستهلكين المزودة بوحدة معالجة رسومات متواضعة سعتها 4 غيغابايت على الأقل من . يمثل هذا تحولًا عن نماذج "النص إلى الصورة" السابقة مثل دال-إي وميدجورني التي كان يمكن الوصول إليها فقط عبر الخدمات السحابية.
ومن جهة أخرى، يستعمل بشكل أساسي لإنشاء صور مفصلة مشروطةً بأوصاف نصية، على الرغم من أنه يمكن تطبيقه كذلك على مهام أخرى مثل التلوين الداخلي والخارجي، وتوليد ترجمات من صورة إلى أخرى موجهة بمطالبة نصية. طوره باحثين من مجموعة "كومبفيز" في جامعة لودفيغ ماكسيميليان في ميونيخ بالتعاون مع شركة رن واي، وبدعم مالي من شركة ستابيليتي أيه آي، وبيانات تدريب من منظمات غير ربحية.
إجراءات التدريب
إضافةً إلى ذلك، ولضمان جودة الصور، استُبعدت الصور منخفضة الدقة والصور التي تحمل علامات مائية (والتي حددها نموذج بنسبة احتمال تجاوزت 80%). كما حُذفت عشرة بالمائة من بيانات التدريب النصية في المراحل النهائية لتحسين عملية الانتشار التوليدي.
بلغت تكلفة تدريب النموذج SD3 نحو عشرة ملايين دولار أمريكي.
كذلك، دُرب النموذج مبدئيًا على مجموعتي البيانات الفرعيتين و، ثم خضع لتدريب نهائي مكثف على مجموعة الضخمة التي تضم 600 مليون صورة مصحوبة بأوصاف نصية. وقد اختيرت هذه الصور بدقة بناءً على تقييمات نموذج الذي تنبأ بإعجاب البشر بها بدرجة لا تقل عن خمسة من عشرة.
من جانب آخر، استغرقت عملية تدريب النموذج 150 ألف ساعة عمل لوحدات معالجة الرسوميات من نوع إنفيديا A100، وذلك باستخدام خدمات الحوسبة السحابية من أمازون ويب. وقد بلغت التكلفة الإجمالية للتدريب نحو 600 ألف دولار أمريكي.
تعديل الصورة
ومن جهة أخرى، تم تقديم نموذج جديد يعتمد على مفهوم العمق، أُطلق عليه اسم "عمق إلى صورة" ، وذلك بالتزامن مع إصدار النسخة الثانية من برنامج ستابل ديفيوجن في 24 نوفمبر 2022. يستطيع هذا النموذج أن يستخلص معلومات العمق من أي صورة يعمل عليها، ثم يقوم بإنشاء صورة جديدة تستجيب للمطالبة النصية مع الحفاظ على عمق الصورة الأصلية. وبذلك، يضمن النموذج الجديد الحفاظ على الاتساق والعمق في الصورة الناتجة.
وفي هذا الصدد، يستعمل نموذج "ستابل ديفوجن" برنامجًا نصيًا آخر يُعرف بـ "صورة إلى صورة" . يتلقى هذا البرنامج مطالبة نصية ومسارًا لصورة موجودة وقيمة عددية تتراوح بين صفر وواحد. ينتج البرنامج صورة جديدة مستندة إلى الصورة الأصلية مع إضافة عناصر تتوافق مع المطالبة النصية. تحدد القيمة العددية المقدمة كمية الضوضاء التي تُضاف إلى الصورة الناتجة. بزيادة هذه القيمة، يزداد التنوع في الصورة الناتجة، إلا أنه قد ينتج عن ذلك صورة لا تتسق دلاليًا مع المطالبة المقدمة.
ومن ناحية أخرى، تتيح الكثير من التطبيقات الأمامية لنموذج "ستابل ديفوجن" إمكانيات إضافية لتعديل الصور بطريقة "صورة إلى صورة". ومن بين هذه الإمكانيات، نجد عملية "الالتصاق" التي تسمح بتعديل جزء محدد من صورة موجودة. يتم تحديد هذا الجزء بواسطة قناع طبقة يوفره المستعمل، ثم يتم ملء المساحة المحددة بمحتوى جديد يتم توليده بناءً على وصف نصي يقدمه المستعمل. وقد طورت شركة "ستابيليتي أيه آي" نموذج متخصص ومعدل خصيصًا لمهام الالتصاق هذه، وذلك بالتزامن مع إطلاق الإصدار الثاني من نموذج "ستابل ديفوجن". وبجانب عملية الالتصاق، توجد عملية أخرى تسمى "الالتصاق الخارجي" والتي تعمل على توسيع الصورة خارج أبعادها الأصلية، ويتم ملء المساحة الإضافية بمحتوى جديد يتم توليده بناءً على وصف نصي يقدمه المستعمل.
وفي هذا السياق، تُمكّن قدرة تقنية "صورة إلى صورة" من إضافة تشويش بصري إلى الصورة الأصلية، مما يجعلها أداة واعدة في مجال إخفاء الهوية وتعزيز البيانات. إذ يتم من خلال هذه التقنية تعديل الملامح البصرية للصورة وإخفاء هويتها الأصلية. ولا يقتصر دور هذه العملية على إخفاء الهوية فقط، بل يمكن الاستفادة منها كذلك في تحسين دقة الصورة وزيادة التفاصيل بها. وقد خضعت تقنية "ستابل ديفوجن" لتجارب لاستخدامها في ضغط الصور. ورغم ذلك، كشفت المقارنات مع تقنيات الضغط التقليدية مثل جيه بيه إي جي وويب بي عن وجود قيود في قدرة "ستابل ديفوجن" على الحفاظ على جودة النصوص الصغيرة والوجوه عند تطبيق عملية الضغط.
وفي السياق ذاته، تتعدد الطرق لتحويل الصورة إلى صورة أخرى، ومن أبرزها طريقة "SDEdit" التي تعتمد على إضافة ضوضاء إلى الصورة الأصلية، ثم إزالتها بطريقة مشابهة لعملية تحويل النص إلى صورة.
التنمية
وفي هذا الصدد، نشأ ستيبل ديفيوجن من مشروع يسمى ، طوره باحثين في جامعة لودفيغ ماكسيميليان في ميونخ وجامعة هايدلبرغ. لاحقًا انضم أربعة من المؤلفين الخمسة الأصليين وهم (روبن رومباخ، وأندرياس بلاتمان، وباتريك إيسر، ودومينيك لورينز) إلى شركة "ستابيليتي أيه آي" وأصدروا إصدارات لاحقةً من ستيبل ديفيوجن.
في هذا الإطار، أصدرت مجموعة كومبفيز في جامعة لودفيغ ماكسيميليان في ميونيخ الترخيص التقني للنموذج. قاد فريق التطوير باتريك إيسر من "رن واي"، و"روبن رومباخ" من كومبفيز، اللذان كانا من بين الباحثين الذين اخترعوا سابقًا بنية نموذج التي يستعملها ستيبل ديفيوجن. كما أشادت شركة ستابيليتي أيه آي بـ "إليوثر أيه آي - "، و"لايون" (وهي منظمة ألمانية غير ربحية جمعت البيانات التي دُرب ستيبل ديفيوجن عليها) لدعمهم المشروع.
التكنولوجيا
واجهات المستخدم
الإصدارات
ومن جهة أخرى، تُوفر شركة "ستابيليتي أيه آي" خدمةً لتوليد الصور عبر الإنترنت تُسمى دريم ستوديو. كما أصدرت نسخة مفتوحة المصدر من دريم ستوديو تُسمى ستابل ستوديو. علاوةً على ذلك، توجد الكثير من الواجهات مفتوحة المصدر من جهات خارجية، مثل "ستيبل ديفيوجن ويب يو آي"، والتي تُعد الأكثر شيوعًا وتوفر ميزات إضافية، و"فوكس" التي تهدف إلى تقليل كمية المطالبات المطلوبة من المستعمل، و"كومفي يو آي" التي تمتلك واجهة مستعمل مبنية على العقد، وهي في الأساس لغة برمجة مرئية شبيهة بالعديد من تطبيقات نمذجة ثلاثية الأبعاد.
القيود
إضافةً إلى ذلك، يُقرّ مبتكرو نموذج ستيبل ديفيوجن بوجود احتمال التحيز الخوارزمي، حيث دُرب النموذج بشكل أساسي على صور مصحوبة بأوصاف باللغة الإنجليزية. ونتيجة لذلك، تعكس الصور الناتجة عن النموذج التحيزات الاجتماعية السائدة في المنظور الغربي، إذ لاحظ المبتكرون نقصًا في البيانات المستمدة من مجتمعات وثقافات أخرى. كما يقدم النموذج نتائج أدق للمطالبات المصاغة باللغة الإنجليزية مقارنةً باللغات الأخرى، وغالبًا ما تكون الثقافات الغربية أو البيضاء هي التمثيل الافتراضي.
إضافةً إلى ذلك، تواجه تقنية "الانتشار المستقر" تحديات تتعلق بتدهور جودة الصور وعدم دقتها في بعض الحالات. فقد تم تدريب النسخ الأولية من هذا النموذج على مجموعة بيانات تضم صورًا بدقة 512×512 بكسل، مما يؤدي إلى تدهور ملحوظ في جودة الصور الناتجة عند ابتعاد مواصفات المستعمل عن هذه الدقة المحددة مسبقًا. وقد قدم الإصدار الثاني من النموذج لاحقًا إمكانية توليد صور بدقة أعلى تصل إلى 768×768 بكسل.
من جهة ثانية، قد يُشكّل توافر المطورين الأفراد عائقًا إضافيًّا. فلتخصيص النموذج لحالات استخدام جديدة لم تغطها مجموعة البيانات التدريبية، كما في حالة نموذج "وايفو ديفيوجن" لتوليد شخصيات الأنمي، يتطلب الأمر جمع بيانات جديدة وإجراء تدريب إضافي. وقد استُخدمت تعديلات دقيقة على نموذج "ستيبل ديفيوجن" نتجت عن إعادة تدريب إضافية لتغطية مجموعة واسعة من التطبيقات، بدءًا من التصوير الطبي، ووصولًا إلى توليد الموسيقى خوارزميًّا. إلا أن عملية الصقل الدقيق هذه حساسة لجودة البيانات الجديدة؛ فالصور منخفضة الدقة أو ذات جودة مختلفة عن البيانات الأصلية لا تؤدي فقط إلى الفشل في تعلم المهمة الجديدة، بل تساهم كذلك في تدهور الأداء العام للنموذج. وحتى مع تدريب النموذج على صور عالية الجودة، يواجه الأفراد تحديًا في تشغيل النماذج على الأجهزة الاستهلاكية. فمثلًا، يتطلب تدريب نموذج "وايفو ديفيوجن" ذاكرة وصول عشوائي للفيديو لا تقل عن 30 جيجابايت ، وهو ما يتجاوز الموارد المتاحة عادة في وحدات معالجة الرسوميات الاستهلاكية مثل سلسلة جيفورس 30 من إنفيديا، التي تبلغ سعتها نحو 12 جيجابايت فقط.
من جهة ثانية، ومن التحديات الأخرى التي تواجه هذا النموذج هي صعوبة توليد صور واقعية للأطراف البشرية، وذلك بسبب ضعف جودة بيانات الأطراف المتوفرة في قاعدة البيانات المستعملة في التدريب. ولم يدُرب النموذج بشكل كافٍ لفهم تفاصيل الأطراف والوجوه البشرية نتيجة نقص السمات التمثيلية في قاعدة البيانات، مما قد يؤدي إلى نتائج غير متوقعة عند محاولة توليد صور بهذه التفاصيل. وقد تم إطلاق الإصدار الأول من "الانتشار المستقر إكس إل" (SDXL) في يوليو 2023، والذي يوفر دقة أعلى تصل إلى 1024×1024 بكسل وتحسينًا في توليد الأطراف والنص.
الرخصة
- انظر كذلك
- فن الذكاء الاصطناعي
- ميدجورني
- دال-إي
- جوجل برين
وفي هذا السياق، بخلاف نماذج مثل دال-إي، تتيح "ستيبل ديفيوجن" كودها المصدري للعموم، فضلًا عن النموذج ذاته (الأوزان المدربة مسبقًا). وقبل الإصدار الثالث من "ستيبل ديفيوجن"، كان النموذج يخضع للترخيص الإبداعي "إم إل أوبن آر إيل-إم" ، وهو نوع من تراخيص الذكاء الاصطناعي المسؤول. يحظر هذا الترخيص بعض الاستخدامات، مثل ارتكاب الجرائم والتشهير والتحرش واستقاء المعلومات الشخصية والتشهير الإلكتروني واستغلال القصر وتقديم المشورة الطبية وإنشاء الالتزامات القانونية تلقائيًا وإنتاج الأدلة القانونية والتمييز ضد الأفراد أو الجماعات أو إيذائهم بناءً على السلوك الاجتماعي أو الخصائص الشخصية أو الفئات المحمية قانونًا. ويحتفظ المستعمل بحقوق الملكية للصور التي يولدها، ويجوز له استخدامها لأغراض تجارية.
وفي هذا السياق، يعتمد الإصدار 3.5 من نموذج ستيبل ديفيوجن على ترخيص مجتمعي مفتوح صادر عن شركة ستابيليتي أيه آي، في حين تشترط الشركة الترخيص التجاري على الشركات التجارية التي تتجاوز إيراداتها السنوية مليون دولار أمريكي. وعلى غرار ترخيص أوبن آر إيل-إم، يحتفظ المستعمل بحقوق الملكية الكاملة للصور التي ينتجها باستخدام هذا النموذج، ويتسنى له استخدامها في الأغراض التجارية دون قيود.
ضبط المستخدم النهائي
علاوةً على ذلك، "الشبكة الفائقة" هي شبكة عصبية صغيرة مدربة مسبقًا يتم تطبيقها على نقاط مختلفة داخل شبكة عصبية أكبر، وتشير إلى التقنية التي ابتكرها مطور "نوفل أيه آي كوروموز" في سنة 2021، والمخصصة في الأصل لنماذج محولات توليد النصوص. توجه الشبكات الفائقة النتائج نحو اتجاه معين، مما يسمح للنماذج القائمة على الانتشار المستقر بتقليد أسلوب الفن لفنانين معينين، حتى لو لم يتم التعرف على الفنان من قبل النموذج الأصلي؛ فهي تعالج الصورة من خلال العثور على مناطق رئيسية ذات أهمية مثل الشعر والعينين، ثم ترقيع هذه المناطق في مساحة كامنة ثانوية.
كذلك، لتجاوز القيود المفروضة على التدريب الأولي للنموذج، قد يقرر المستعملون النهائيون إجراء تدريب إضافي لضبط مخرجات التوليد بدقة بحيث تتوافق مع حالات استخدام محددة، وهي عملية تعرف كذلك بالتخصيص. هناك ثلاث طرق يمكن للمستعملين من خلالها تطبيق الضبط الدقيق على نقطة تفتيش نموذج الانتشار المستقر:
وعلى صعيد آخر، يمكن تدريب "التضمين" على مجموعة من الصور يزودها المستعمل، مما يُمكّن النموذج من توليد صور مماثلة بصريًا كلما استُخدم اسم التضمين ضمن موجه الإنشاء. وتستند عمليات التضمين إلى مفهوم "عكس النص" الذي طوره باحثون من جامعة تل أبيب عام 2022 بدعم من إنفيديا، حيث يتم ربط التمثيلات المتجهية للرموز المحددة التي يستعملها مشفر نص النموذج بكلمات زائفة جديدة. ويمكن توظيف عمليات التضمين لتقليل التحيزات الكامنة في النموذج الأصلي أو لمحاكاة الأنماط البصرية.
من جهة ثانية، "دريمبوث" هو نموذج توليدي للتعلم العميق طوره باحثون من غوغل للأبحاث وجامعة بوسطن عام 2022، وهو قادر على تعديل النموذج ليولد مخرجات دقيقة ومخصصة تصوّر موضوعًا محددًا، وذلك بعد تدريبه على مجموعة من الصور التي تصوّر هذا الموضوع.
الاستخدام والجدل
كذلك، يتميز نموذج "ستابل ديفيوجن" بمرونة أكبر في توليد أنواع مختلفة من المحتوى، بما في ذلك المحتوى العنيف أو الجريء جنسياً، مقارنة بمنتجات الذكاء الاصطناعي التوليدية الأخرى المتاحة تجارياً. وفي مواجهة المخاوف المتعلقة بإساءة استعمال هذا النموذج، يرى الرئيس التنفيذي لشركة "ستابيليتي أيه آي"، أن "المسؤولية تقع على عاتق الأفراد في التعامل مع هذه التكنولوجيا بشكل أخلاقي وقانوني". ويؤكد مشتاق أن جعل قدرات "ستابل ديفيوجن" متاحة للجمهور بشكل واسع سيؤدي إلى تحقيق فوائد صافية للتكنولوجيا، رغم وجود بعض الآثار الجانبية المحتملة. ويرى مشتاق كذلك أن الهدف من جعل "ستابل ديفيوجن" مفتوح المصدر هو كسر الاحتكار الذي تمارسه الشركات الكبرى على هذه التقنيات، حيث كانت هذه الشركات تقتصر على تطوير أنظمة ذكاء اصطناعي مغلقة لتوليد الصور. ويتجلى ذلك في سهولة تجاوز أي قيود تفرضها شركة "ستابيليتي أيه آي" على المحتوى الذي يمكن توليده، وذلك بفضل توفر رمز المصدر.
إضافةً إلى ذلك، أثير جدل واسع حول انتشار صور مزيفة أنتجها نموذج "ستابل ديفيوجن" المدعوم بالذكاء الاصطناعي. تصور هذه الصور أشخاصًا حقيقيين بطريقة مبتذلة ومخلة بالآداب، ولا سيما القصر، وقد بلغ هذا الجدل ذروته عند انتشار تلك الصور على منصات مثل بكسيف.
إضافةً إلى ذلك، تؤكد "ستابيليتي أيه آي" على عدم وجود أي حقوق ملكية للصور التي يولدها النموذج، وتمنح المستعملين الحرية التامة في استخدام هذه الصور، شريطة ألا يكون محتوى الصورة مخالفًا للقانون أو مسيئًا للأفراد. وقد دُرب النموذج على مجموعة ضخمة من الصور دون تدخل بشري، مما أدى إلى ظهور بعض الصور الضارة وكميات كبيرة من البيانات الشخصية والحساسة في بيانات التدريب. وقد أعرب الفنانون البصريون التقليديون عن قلقهم من أن الاستخدام الواسع لبرامج توليد الصور مثل "ستابل ديفيوجن" قد يؤدي في النهاية إلى تآكل قدرات الفنانين البشرية، بما في ذلك المصورين والممثلين والمنتجين السينمائيين، وذلك بسبب المنافسة المتزايدة من التقنيات المدعومة بالذكاء الاصطناعي.
في هذا الإطار، وفي حادثة أخرى، تعرضت واجهة المستعمل "كومفي يو آي" لهجوم إلكتروني في يونيو عام 2024. زعم القراصنة أنهم استهدفوا مستعملي هذه الأداة الذين ارتكبوا ما وصفوه بـ"الخطايا"، والتي شملت إنتاج أعمال فنية مستعملين الذكاء الاصطناعي وسرقة أعمال فنية أخرى والترويج للعملات المشفرة.
مدة التدريب
علاوةً على ذلك، بلغت مدة تدريب نموذج "ستيبل ديفيوجن 2.0" قرابة 0.2 مليون ساعة على وحدة معالجة رسوميات من نوع إنفيديا A100 بسعة 40 جيجابايت.
بيانات التدريب
- دُرب النموذج على ثلاث مجموعات فرعية محددة من "لايون-5 بي" وهي:
- "لايون2 بي-إي إن"
- "لايون-هاي-ريزوليوشن"
- "لايون-إستيتيكس في2 5+" .
إضافةً إلى ذلك، كشفت تحليلات خارجية لبيانات التدريب المستعملة في هذا النموذج أن نحو 47% من عينة عشوائية تضم 12 مليون صورة مأخوذة من المجموعة الأصلية الأكبر كانت مستمدة من 100 نطاق مختلف على الويب. وقد استحوذ موقع بنترست على نسبة 8.5% من هذه العينة، تلاه مواقع أخرى مثل ووردبريس، وبلوغر، وفليكر، وديفيانت آرت وويكيميديا كومنز. كما أظهر تحقيق أجرته هيئة البث البافارية (بايريشر روندفونك) أن مجموعات بيانات "لايون" المتاحة على منصة "هجينج فيس" تحتوي على كميات كبيرة من البيانات الحساسة والخاصة.
في هذا الإطار، دُرب نموذج "الانتشار الثابت" على أزواج من الصور والتعليقات التوضيحية مستمدة من قاعدة البيانات الضخمة "لايون-5 بي" ، وهي مجموعة بيانات عامة المصدر اشتقت من بيانات المستخرجة من الويب. تم تصنيف نحو خمسة مليارات زوج من الصور والنصوص ضمن هذه المجموعة بناءً على اللغة، في مجموعات بيانات منفصلة استنادًا إلى دقة الصورة، واحتمالية وجود علامة مائية، والتقييم الجمالي المتوقع (مثل الجودة البصرية). وتجدر الإشارة إلى أن منظمة ، وهي مؤسسة ألمانية غير ربحية تدعمها شركة "ستابيليتي أيه آي"، هي المسؤولة عن إنشاء هذه المجموعة الضخمة من البيانات.
الأوراق الرئيسية
من جهة ثانية، توضح هذه الورقة طريقة CFG، التي تمكن متجه التشفير النصي من توجيه نموذج الانتشار نحو إنشاء الصورة التي يصفها النص.
وفي هذا الصدد، توضح هذه الورقة طريقة CLIP لتدريب مشفرات النصوص، التي تحول النصوص إلى متجهات فاصلة عائمة. تستعمل هذه التشفيرات النصية من قبل نموذج الانتشار لخلق الصور.
- (صدرت في 2023).
- تصف SDXL.
- (صدرت في 2022).
- تصف التدفق المعدل، الذي يتم استخدامه لبنية العمود الفقري لـ SD 3.0.
- (صدرت في 2024).
- تصف SD 3.0.
- (صدرت في 2021).
- تصف هذه الورقة SDEdit، المعروفة كذلك باسم "img2img".
- (صدرت 2021، وحُدثت في 2022).
إضافةً إلى ذلك، تصف هذه الورقة نموذج الانتشار الكامن (LDM). وهو العمود الفقري لبنية ستيبل ديفيوجن.
(صدرت في 2021).
(صدرت في 2022).
إصدار XL
في هذا الإطار، يستعمل إصدار "XL" البنية المعمارية ذاتها لنموذج الانتشار الكامن (LDM) المستعملة في الإصدارات السابقة، مع زيادة في الأبعاد: شبكة "يو نت" أوسع، سياق انتباه متقاطع أطول، مشفرين نصيين بدلًا من مشفر واحد، وتدريب على نسب أبعاد متعددة (بخلاف النسبة المربعة للعرض إلى الارتفاع في الإصدارات السابقة).
ومن ناحية أخرى، أُصدر "SD XL Refiner" بالتزامن مع الإصدار الأساسي، وله بنية مطابقة لبنية الإصدار "SD XL"، إلا أنه تدرب على إضافة التفاصيل الدقيقة إلى الصور الموجودة مسبقًا عبر عملية "img2img" الشرطية للنص.
الإصدار 3.0
إضافةً إلى ذلك، أُطلق على هذه البنية المبتكرة اسم "المحول الانتشاري متعدد الوسائط" (MMDiT)، حيث تشير صفة "متعدد الوسائط" إلى قدرته على دمج ترميزات النص والصورة معًا داخل عملياتها. يميز هذا الإصدار عن سابقاته من نماذج DiT، حيث يكون تأثير ترميز النص على ترميز الصورة متبادلاً، وليس أحادي الاتجاه.
من جانب آخر، أحدث الإصدار 3.0 تحولًا جذريًا في البنية الأساسية للشبكة العصبية. فقد استُبدلت شبكة "يو نت" بشبكة أكثر تطوراً، ألا وهي "محول التدفق المعدل" (Rectified Flow Transformer). تعتمد هذه الشبكة على تطبيق طريقة التدفق المصحح باستخدام المحول.
وفي السياق ذاته، تتألف بنية التحويل الذاتي المستعملة في الإصدار 3.0 من ثلاثة "مسارات" رئيسية: الأول مخصص لترميز النص الأصلي، والثاني لترميز النص المُحول، والثالث لترميز الصورة (في الفضاء الكامن). يتم دمج ترميز النص المُحول مع ترميز الصورة بشكل متكرر خلال كل كتلة من كتل التحويل.
صور غيتي ضد ستابيليتي أيه آي
وفي هذا الصدد، يدور النزاع في هذه الدعوى حول انتهاك الحقوق الثانوية حول ما إذا كان برنامج "ستيبل ديفيوجن" المدرب مسبقًا، والذي يتوفر في المملكة المتحدة عبر منصات مثل غيت هاب، وهوجينج فيس، ودريم ستوديو، يُعد عملًا "مُصنفًا" بحسب ما نصت عليه المادتان 22 و23 من قانون حقوق المؤلف. وتتمثل المسألة الجوهرية التي ستحسمها المحكمة في تحديد ما إذا كان مصطلح "المصنف" يشمل الكيانات غير الملموسة مثل البرامج الحاسوبية.
من جهة ثانية، تدّعي شركة "غيتي إيميجز" أن نموذج الذكاء الاصطناعي "ستيبل ديفيوجن" قد تم تدريبه وتطويره باستخدام صورها دون الحصول على إذن مسبق، حيث تم تحميل هذه الصور على خوادم وأجهزة حاسوب يرجح وجودها في المملكة المتحدة. إلا أن شركة ستابيليتي أيه آي، صاحبة النموذج، تُدافع عن نفسها مؤكدةً أن جميع عمليات التدريب والتطوير تمت خارج الأراضي البريطانية، وتحديدًا في مراكز بيانات شركة أمازون ويب المتواجدة في الولايات المتحدة.
تشمل النقاط الرئيسية للدعوى القضائية:
علاوةً على ذلك، قدمت شركة "ستابيليتي أيه آي" طلبًا قضائيًا عاجلًا لإلغاء أو شطب ادعاءين هما "التدريب والتطوير"، و"الانتهاك الثانوي" لحقوق النشر. ومع ذلك، رفضت المحكمة العليا هذا الطلب، مما مكن المدعي من المضي قدمًا في الدعوى. ومن المقرر أن تبحث المحكمة في مسألة ما إذا كان تدريب وتطوير نموذج ستيبل ديفيوجن قد حدث في المملكة المتحدة، وهي مسألة جوهرية لتحديد الاختصاص القضائي للمحكمة بموجب قانون حقوق النشر والتصاميم والبراءات لعام 1988 في المملكة المتحدة.
من جهة ثانية، ومن المتوقع أن تُعقد المحاكمة صيف عام 2025، وستكون لها آثار بالغة على قانون حق المؤلف في المملكة المتحدة وتراخيص المحتوى الذي يُولَّد بواسطة الذكاء الاصطناعي.
كذلك، في يناير 2023، بدأت صور غيتي إجراءات قانونيةً ضد ستابيليتي أيه آي في المحكمة العليا الإنجليزية، زاعمةً انتهاكًا كبيرًا لحقوق الملكية الفكرية الخاصة بها. تزعم صور غيتي أن ستابيليتي أيه آي "كشطت" ملايين الصور من مواقع غيتي على الويب دون موافقة واستعملت هذه الصور لتدريب وتطوير نموذج ستيبل ديفيوجن للتعلم العميق الخاص بها.
البنية المعمارية
من جانب آخر، بفضل ما يزيد عن 860 مليون معلمة في شبكة يو-نت و123 مليون في مشفر النص، يُعد نموذج "الانتشار المستقر" خفيف الوزن نسبيًا مقارنة بغيره من النماذج في عام 2022. مما أتاح تشغيله، على عكس نظرائه، على وحدات معالجة الرسوميات المتاحة للمستهلكين، بل وحتى على وحدات المعالجة المركزية وحدها عند استخدام نسخة "أوبن فينو" من هذا النموذج.
ومن ناحية أخرى، يعمل المشفر التلقائي التبايني على ضغط الصورة من مساحة البكسلات إلى مساحة كامنة ذات أبعاد أقل، محتفظًا بالمعنى الدلالي الأساسي للصورة. وتُطبق الضوضاء الغاوسية بشكل متكرر على التمثيل الكامن المضغوط خلال عملية الانتشار الأمامي. وتعمل كتلة شبكة يو-نت، المبنية على بنية شبكة ريزنت، على إزالة الضوضاء من مخرجات الانتشار الأمامي بشكل عكسي للحصول على تمثيل كامن. وأخيرًا، يقوم المشفر التلقائي التبايني بتوليد الصورة النهائية بتحويل التمثيل إلى بكسلات.
من جانب آخر، يمكن أن تخضع عملية إزالة الضوضاء لشروط مرنة ومتنوعة، سواء كانت نصية أو بصرية أو من نوع آخر. تُعرض هذه الشروط المشفرة على شبكات عصبية مخصصة لإزالة الضوضاء، وذلك عبر آلية الانتباه التبادلي. وفي حالة الشروط النصية، يتم استخدام مشفر نص ثابت مدرب مسبقًا، وهو "كليب فيت-إل/14" ، لتحويل العبارات النصية إلى تمثيل رقمي مضغوط.
ومن جهة أخرى، يرى الباحثون أن نماذج الانتشار الكامنة تتميز بزيادة الكفاءة الحسابية أثناء التدريب والتوليد. وقد اشتق اسم "الانتشار" من ظاهرة الانتشار الحراري في الفيزياء، حيث أظهرت الدراسات ارتباطًا وثيقًا بين هذا المجال والتعلم العميق عام 2015.
من جهة ثانية، تعتمد النماذج في سلسلة "ستابل ديفوجن" قبل الإصدار الثالث على نوع من نماذج الانتشار يعرف بـ "نموذج الانتشار الكامن"، وهو نموذج طوره فريق "كومبفيس" (الرؤية الحاسوبية والتعلم الآلي) في جامعة لودفيغ ماكسيميليان في ميونخ. وتُدرب نماذج الانتشار التي ظهرت في عام 2015 على هدف إزالة التطبيقات المتتالية للضوضاء على صور التدريب، مما يجعلها بمثابة سلسلة تشفير ذاتي. ويتكون "ستابل ديفوجن" من ثلاثة أجزاء رئيسية: المشفر التلقائي التبايني (VAE)، وشبكة يو-نت، ومشفر نص اختياري.
القدرات
ومن ناحية أخرى، يدعم النموذج توليد صور جديدة بالكامل باستخدام مطالبات نصية تصف العناصر المراد تضمينها أو استبعادها من الناتج. كما يمكن لهذا النموذج أن يعيد رسم الصور الحالية بإضافة عناصر جديدة إليها، ويتم ذلك بتقديم نص دقيق للعناصر المطلوبة في عملية تُعرف بتوليف الصور الموجه. وتتم هذه العملية عبر آلية إزالة الضوضاء بالانتشار. فضلًا عن ذلك، يسمح النموذج كذلك بتعديل الصور الموجودة جزئيًا عن طريق الإكمال الداخلي والخارجي، عند استخدامه مع واجهة مستعمل مناسبة تدعم هذه الميزات، والتي يوجد العديد منها مفتوحة المصدر.
في هذا الإطار، يوصى بتشغيل النموذج باستخدام ذاكرة الوصول العشوائي للفيديو (VRAM) سعتها 10 جيجابايت أو أكثر. ومع ذلك، يمكن للمستعملين الذين يملكون ذاكرة فيديو أقل أن يختاروا تحميل الأوزان بدقة نقطية float16 بدلًا من الدقة الافتراضية float32، وذلك لتحقيق توازن بين أداء النموذج وتقليل استهلاك الذاكرة.
شبكة التحكم
ومن ناحية أخرى، شبكة التحكم هي بنية عصبية صُمِّمت خصيصًا لإدارة نماذج الانتشار عبر إدماج شروط إضافية. تعمل هذه الشبكة على استنساخ أوزان كتل الشبكة العصبية الأصلية إلى نسختين: نسخة "ثابتة" وأخرى "قابلة للتدريب". تتولى النسخة "القابلة للتدريب" مهمة تعلم الشرط المطلوب، في حين تحافظ النسخة "الثابتة" على النموذج الأصلي دون تغيير. تضمن هذه الآلية عدم المساس بسلامة نماذج الانتشار الجاهزة للإنتاج عند تدريبها على مجموعات بيانات صغيرة من أزواج الصور.
توليد النص إلى الصورة
إضافةً إلى ذلك، يستنفد البرنامج النصي المتوفر في برنامج استقرار الانتشار، المعروف بـ "نص إلى صورة" ، موجهًا نصيًا فضلًا عن مجموعة متنوعة من معاملات الخيارات التي تشمل أنواع أخذ العينات وأبعاد صورة الناتج وقيم البذور. يخرج البرنامج النصي ملف صورة بناءً على تفسير النموذج للموجه. تُوضع علامة مائية رقمية غير مرئية على الصور الناتجة للسماح للمستعملين بتحديد الصورة على أنها مولدة بواسطة استقرار الانتشار، رغم أن هذه العلامة المائية تفقد فعاليتها إذا تم تغيير حجم الصورة أو تدويرها.
من جهة ثانية، توفر واجهات المستعمل الأمامية لنموذج ستيبل ديفيوجن ميزات إضافية تسمح للمستعملين بتعديل الوزن الممنوح لأجزاء معينة من المطالبة النصية، مثل زيادة أو تقليل التأكيد على الكلمات الرئيسية عن طريق إحاطتها بأقواس. تُعدّ "المطالبات السلبية" طريقة بديلة لضبط الوزن لأجزاء من المطالبة، وهي ميزة مدرجة في بعض التطبيقات الأمامية، مثل خدمة "دريم ستوديو" السحابية الخاصة بشركة "ستابيليتي أيه آي"، والتي تسمح للمستعمل بتحديد مطالبات يجب على النموذج تجنبها أثناء توليد الصورة.
ومن ناحية أخرى، تتضمن كل صورة مولدة من "نص إلى صورة" قيمة بذرة محددة تؤثر على صورة الناتج. قد يختار المستعملون تعيين البذرة عشوائيًا لاستكشاف مخرجات مولدة مختلفة، أو استخدام نفس البذرة للحصول على ناتج مماثل لصورة تم إنشاؤها سابقًا. يمكن للمستعملين كذلك ضبط عدد خطوات الاستدلال لأخذ العينات؛ تستغرق القيمة الأعلى مدة زمنية أطول، ومع ذلك، قد تؤدي القيمة الأقل إلى عيوب مرئية. يسمح خيار آخر قابل للتكوين وهو قيمة مقياس التوجيه الخالي من التصنيف، للمستعمل بتعديل مدى التزام صورة الناتج بالموجه. قد تختار حالات الاستخدام الأكثر تجريبية قيمة مقياس أقل، بينما قد تستعمل حالات الاستخدام التي تهدف إلى مخرجات أكثر تحديدًا قيمة أعلى.
التقاضي
كذلك، أندرسن ومكيرنان وأورتي ضد ستابيليتي أيه آي، وميدجورني، وديفيانت آرت
من جهة ثانية، في يناير 2023 رفعت كل من سارة أندرسن وكيلي مكيرنان وكارلا أورتيز، وهن ثلاث فنانات، دعوى قضائية ضد كل من شركتي ستابيليتي أيه آي وميدجورني ومنصة "ديفيانت آرت"، متهمات إياهن بانتهاك حقوق ملايين الفنانين. وقد استندت الدعوى إلى ادعاء بأن الشركات المذكورة قامت بتدريب أدواتها المعتمدة على الذكاء الاصطناعي على خمسة مليارات صورة جُمعت من شبكة الإنترنت دون الحصول على موافقة مسبقة من أصحاب حقوق الملكية الفكرية لهذه الصور. وفي يوليو من العام نفسه، أصدر القاضي الأمريكي وليام أوريك قرارًا قضى برفض أغلب المطالب الواردة في الدعوى. ومع ذلك، فقد سمح القاضي للفنانات بتقديم شكوى معدلة، مما أتاح لهن فرصة لإعادة صياغة حججهن القانونية وتقديم أدلة جديدة لدعم دعواهن.
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟