صيغة التحويل الموحد-8
المحتويات
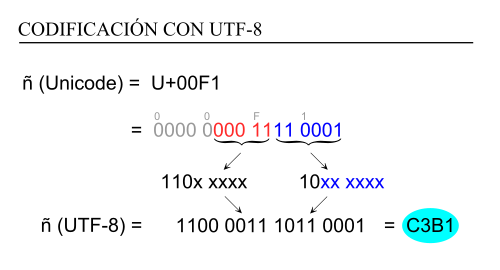
قبل الخوض في التفاصيل، صيغة التحويل الموحد-8 هي اختصار للمصطلح (8-bit Unicode Transformation Format) الذي يترجم إلى صيغة تحويل نظام الحروف الدولي الموحد بقوة 8 بت. هذا الترميز وضع من قبل كل من روب بايك وكين تومسن لتمثيل معيار نظام الحروف الدولي الموحد للحروف الأبجدية لأغلب لغات العالم، ويتم تشفير الرموز فيه في حجم يتراوح بين بايت واحد وأربعة بايت للرمز الواحد. وفيما يلي تفاصيل أوسع عن ذلك.
الفرق بين يونيكود وصيغة التحويل الموحد-8
وعلى صعيد آخر، صيغة التحويل الموحد-8 هي تنسيق موجه للبايت ولذلك لا يوجد مشاكل مع الشبكات أو الملفات الموجهة للبايت. صيغة التحويل الموحد-16، من ناحية أخرى، غير موجهة للبايت وتحتاج إلى تأسيس ترتيب بايت من أجل العمل مع الشبكات الموجهة للبايت. صيغة التحويل الموحد-8 هي كذلك أفضل في الاسترداد من الأخطاء التي تتلف أجزاء من الملف أو الدفق بسبب أنه لا يزال بالإمكان فك البايت غير الفاسد التالي. صيغة التحويل الموحد-16 تفعل الشيء نفسه إذا كانت بعض وحدات البايت معطوبة ولكن المشكلة تكمن عند فقدان بعض وحدات البايت. يمكن خلط البايت المفقودة مع وحدات البايت التالية مما يتسبب في تشويه النتيجة النهائية.
ومن جهة أخرى، يونيكود هو قائمة من الأحرف مع أرقام عشرية مميزة لكل حرف. مثلًا C = 67 وB = 66 وA = 65. القائمة التالية من الأرقام العشرية 104 101 108 108 111 تمثل كلمة "hello".
الفرق بين صيغة التحويل الموحد-8 وصيغة التحويل الموحد-16
وفي هذا الصدد، صيغة التحويل الموحد-8 هو ترميز يوضح كيفية ترجمة هذه الأرقام إلى أرقام ثنائية ليتم تخزينها في جهاز الحاسب.بحسب نظام صيغة التحويل الموحد-8.
المعايير
كذلك، هناك الكثير من التعريفات الحالية لصيغة التحويل الموحد-8 في عدة وثائق للمعايير. وتتشابه جميعها في الميكانيكا العامة، مع كون الاختلافات الرئيسية في بعض القضايا مثل النطاق المسموح به من قيم الرمز النقطي والتصرف الآمن للإدخال غير الصالح.
- RFC 3629 / STD 63 (عام 2003) الذي أرسى UTF-8 كعنصر بروتوكول إنترنت قياسي
- RFC 5198 عرف UTF-8 NFC كشبكة تبادل (عام 2008)
- ISO/IEC 10646:2014 (عام 2014)
- The Unicode Standard، النسخة 11.0 (2018)
- وهي تحل محل التعاريف الواردة في الوثائق التالية:
- The Unicode Standard، نسخة 2.0، Appendix A (عام 1996)
- ISO/IEC 10646-1:1993 Amendment 2 / Annex R (عام 1996)
- RFC 2044 (عام 1996)
- RFC 2279 (عام 1998)
- The Unicode Standard، نسخة 3.0 (عام 2000)
- Unicode Standard Annex : Unicode 3.1 (عام 2001)
- The Unicode Standard، نسخة 5.0 (عام 2006)
- The Unicode Standard، نسخة 6.0 (عام 2010)
الإشتقاقات
من جانب آخر، تختلف التطبيقات التالية اختلافات طفيفة عن مواصفات صيغة التحويل الموحد-8. وهي غير متوافقة مع مواصفات صيغة التحويل الموحد-8 ويمكن أن يتم رفضها من قبل التطبيقات المستعملة لصيغة التحويل الموحد-8.
- CESU-8
- MySQL utf8mb3
- Modified UTF-8
- WTF-8
سبب الإنشاء
في هذا الإطار، مجموعات الأحرف في ISO-8859-1 كانت محدودة الحجم وغير متوافقة مع البيئات متعددة اللغات. لهذا السبب، قام مجمع يونيكود بتطوير معيار يونيكود. يغطي معيار يونيكود (على وجه التقريب) جميع الأحرف وعلامات الترقيم والرموز في العالم. يُمكن يونيكود من معالجة وتخزين ونقل النص بغض النظر عن المنصة أواللغة المستعملة.
وعلى صعيد آخر، صيغة التحويل الموحد-8 هي ترميز الأحرف الافتراضية في HTML-5. أما إذا كانت صفحة ويب HTML5 تستعمل مجموعة أحرف مختلفة عن صيغة التحويل الموحد-8، فيجب تحديدها في وسم .
طول تشفير الرمز
من جانب آخر، إذا كان قيمة البايت الأول أقل من 127، أي أن البت الثامن يساوي صفر، فإن هذا البايت هو كامل تشفير الرمز، وبالتالي طوله واحد بايت، تقع قيم أسكي في هذا المجال.
إضافةً إلى ذلك، إذا كان البت الثامن من البايت الأول مساويا لواحد وكذلك البت السابع مساويا لواحد والبت السادس يساوي واحد والخامس يساوي صفر، فإن طول التشفير هو ثلاثة بايت.
وعلى صعيد آخر، إذا كان البت الثامن من البايت الأول مساويا لواحد وكذلك البت السابع مساويا لواحد والبت يساوي واحد والخامس يساوي واحد والرابع يساوي صفر، فإن طول التشفير هو أربعة بايت.
يتم تحديد طول تشفير الرمز بحسب الشكل الآتي:
ومن جهة أخرى، إذا كان البت الثامن من البايت الأول مساويا لواحد وكذلك البت السابع مساويا لواحد والبت السادس يساوي صفر، فإن طول التشفير هو اثنين بايت.
ومن جهة أخرى، لا يجوز أن يكون البت الثامن من البايت الأول مساويا لواحد والبت السابع يساوي صفر، ووقوع مثل هذه الحالة في البايت الأول من التشفير تعني أن هناك خطأ إما في التشفير أو في طريقة القراءة، فهذه القيم مسموحة في البايت الثاني والثالث والرابع ولكن ليس الأول.
علاوةً على ذلك، إذا كان قيمة البايت الأول أكبر من 127، أي أن قيمة البت الثامن تساوي واحد، فإن تشفير الرمز متعدد البايتات يتم حسب الأتي:
التاريخ
وعلى صعيد آخر، المنظمة الدولية للمعايير (ISO) نصت على تشكيل مجموعة أحرف عالمية متعددة البايتات في سنة 1989. يحتوي معيار ISO 10646 على ملحق غير مطلوب يسمى UTF-1 الذي يوفر ترميز لتيار البايت لنقاط التعليمات البرمجية 32 بت. من بين عدة مشاكل، لم يكن أداء هذا الترميز مرضيا. وربما كانت المشكلة الكبرى عدم وجود فصل واضح بين أسكي وغير أسكي. أدوات UTF - 1 الجديدة متوافقة مع النص المرمز بأسكي، ولكن قد تخلط النص المرمز بـ UTF-1 بين التعليمات البرمجية الموجودة التي تتوقع أسكي (أو أسكي الموسع)، لأنها قد تحتوي على وحدات البايت المستمرة في النطاق 0x21-0x7E والتي تعني شيئا آخر في أسكي، مثلًا، 0x2F لـ '/'، وفاصل المسارات في نظام يونكس.
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟