فرز سريع
المحتويات
- مخطط تقسيم هور
- - عرض رسومي
- تاريخ
- return j
- فرز الجذر السريع
- الفرز السريع متعدد المحاور
- swap A[i] with A[hi]
- if lo < hi then
- التمحور القائم على الاختيار
- swap A[mid] with A[hi]
- ثلاث طرق فرز سريع للجذر
- عن التفضيلات والخوارزمية
- باستخدام التكرارات
- if lo < hi then
- فرز سريع خارجي
- اختيار أفضل مؤشر
- التحسينات
- algorithm partition(A, lo, hi) is
- تحسينات أخرى
- كتلة الفرز السريع
- i := lo // place for swapping
- return i
- تحليل أفضل حالة
- تحليل الحالة الأسوأ
- مخطط تقسيم لوموتو
- التوازي
- اختيار المحور
- أولا : نقوم باختيار المحور أو الأساس
- العلاقة بالخوارزميات الأخرى
- if lo < hi then
- استخدام شجرة بحث ثنائية
- عناصر متكررة
- تعميم
- باستخدام النسب المئوية
- if lo < hi then
- hi) // note: multiple return values
- فرز سريع جزئي وتزايدي
- الخوارزمية
- تحليل متوسط الحالة
- تعقيد الفضاء
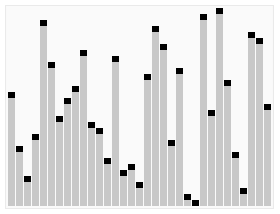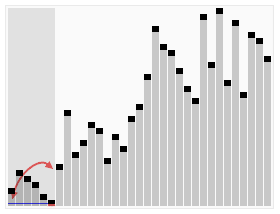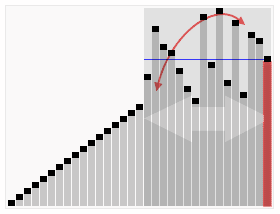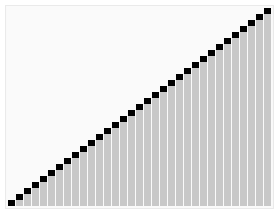
في البداية، الفرز السريع (بالإنجليزية: Quicksort) هي خوارزمية لفرز المصفوفات (تصاعديّا أو تنازليّا) من ابتكار الإنجليزي توني هور في 1961. ونتناول فيما يلي مزيدًا من التفاصيل.
من جانب آخر، الفرز السريع هو خوارزمية فرق تسد. إنه يعمل عن طريق تحديد عنصر «محوري» من المصفوفة وتقسيم العناصر الأخرى إلى مصفوفتين فرعيتين، بحسب ما إذا كانت أقل من المحور أو أكبر منه. لهذا السبب، يطلق عليه أحيانًا فرز تبادل الأقسام. ثم يتم فرز المصفوفات الفرعية بشكل متكرر. يمكن القيام بذلك في نفس المكان، مما يتطلب مساحات إضافية صغيرة من الذاكرة لإجراء الفرز.
وعلى صعيد آخر، يُظهر التحليل الرياضي للفرز السريع أن الخوارزمية، في المتوسط، تأخذ O (n سجل ن) مقارنات لفرز ن العناصر. في أسوأ الحالات، تقوم بإجراء مقارنات O (n 2)، على الرغم من أن هذا السلوك نادر.
من جهة ثانية، كما أن الترتيبال سريع هو نوع للمقارنة، مما يعني أنه يمكنه فرز العناصر من أي نوع يتم تحديد علاقة «أقل من» (رسميًا، فرز إجمالي). لا تعد عمليات التنفيذ الفعالة لـ فرز سريع من النوع المستقر، مما يعني أنه لا يتم الاحتفاظ بالفرز النسبي لعناصر الفرز المتساوية.
كذلك، فرز سريع هي خوارزمية فرز فعالة. تم تطويره بواسطة عالم الكمبيوتر البريطاني توني هور في سنة 1959 ونشر في عام 1961، ولا يزال خوارزمية الفرز شائعة الاستخدام. عندما يتم تنفيذه بشكل جيد، يمكن أن يكون أسرع إلى حد ما من دمج الفرز ونحو مرتين أو ثلاث مرات أسرع من فرز الكومة.
مخطط تقسيم هور
ومن ناحية أخرى، يستعمل مخطط التقسيم الأصلي الذي وصفه توني هور مؤشرين يبدأان في نهايات المصفوفة التي يتم تقسيمها، ثم ينتقلان باتجاه بعضهما البعض، حتى يكتشفوا انعكاسًا: زوج من العناصر، واحد أكبر من أو يساوي المحور، واحد أقل من أو يساوي، بفرز خاطئ بالنسبة لبعضها البعض. ثم يتم تبديل العناصر المقلوبة. عندما تلتقي المؤشرات، تتوقف الخوارزمية وتعيد الفهرس النهائي. يعتبر مخطط هور أكثر كفاءة من مخطط تقسيم لوموتو لأنه يقوم بإجراء مقايضات أقل بثلاث مرات في المتوسط، كما أنه ينشئ أقسامًا فعالة حتى عندما تكون جميع القيم متساوية. ] مثل مخطط تقسيم لوموتو، سيؤدي تقسيم هور كذلك إلى تدهور فرز سريع إلى للمدخلات التي تم فرزها بالفعل، إذا تم اختيار المحور ليكون العنصر الأول أو الأخير. مع وجود العنصر الأوسط كمحور، ينتج عن البيانات المصنفة (على وجه التقريب) عدم وجود مقايضات في أقسام متساوية الحجم تؤدي إلى أفضل سلوك حالة لـ فرز سريع، أي . مثل الآخرين، لا ينتج تقسيم هور نوعًا مستقرًا. في هذا المخطط، لا يكون الموقع النهائي للمحور بالضرورة في الفهرس الذي يتم إرجاعه، حيث يمكن أن ينتهي المحور والعناصر التي تساوي المحور في أي مكان داخل القسم بعد خطوة القسم، وقد لا يتم فرزها حتى الحالة الأساسية لـ يتم الوصول إلى القسم الذي يحتوي على عنصر واحد عبر العودية. المقطعان التاليان اللذان تكررهما الخوارزمية الرئيسية هما (العناصر ≤ المحور) و (العناصر ≥ المحور) مقابل و كما في مخطط لوموتو. ومع ذلك، فإن خوارزمية التقسيم تضمن مما يعني أن كلا القسمين الناتجين غير فارغين، وبالتالي لا يوجد خطر من التكرار اللانهائي. في الكود الزائف، algorithm quicksort(A, lo, hi) is
- عرض رسومي
Open Data Structures - القسم 11.1.2 - فرز سريع، بات مورين
رسم توضيحي تفاعلي لـ فرز سريع، مع تجول التعليمات البرمجية
تاريخ
إضافةً إلى ذلك، في عام 2009، اقترح فلاديمير ياروسلافسكي تطبيق فرز سريع جديدًا باستخدام محورين بدلاً من واحد. في القوائم البريدية لمكتبة جافا الأساسية، بدأ نقاشًا يدعي فيه أن خوارزميته الجديدة متفوقة على طريقة فرز مكتبة وقت التشغيل، والتي كانت تعتمد في ذلك الوقت على المتغير المستعمل على نطاق واسع والمضبوط بعناية من فرز سريع الكلاسيكي بواسطة بنتلي وماكلروي. تم اختيار الفرز السريع لـ ياروسلافسكي كخوارزمية فرز افتراضية جديدة في مكتبة وقت تشغيل جافا 7 من أوراكل بعد اختبارات أداء تجريبية مكثفة.
كذلك، تم تطوير خوارزمية الفرز السريع في سنة 1959 من قبل توني هور عندما كان طالبًا زائرًا في جامعة موسكو الحكومية. في ذلك الوقت، كان هور يعمل على مشروع ترجمة آلية للمختبر الفيزيائي الوطني. كجزء من عملية الترجمة، كان بحاجة إلى فرز الكلمات في الجمل الروسية قبل البحث عنها في قاموس روسي إنجليزي، والذي كان بالفرز الأبجدي على شريط مغناطيسي. بعد أن أدرك أن فكرته الأولى، نوع الإدراج، ستكون بطيئة، توصل إلى فكرة جديدة. لقد كتب جزء القسم في ميركوري أوتوكود ولكنه واجه مشكلة في التعامل مع قائمة المقاطع التي لم يتم فرزها. عند العودة إلى إنجلترا، طُلب منه كتابة رمز لـ الترتيب. ذكر هور لرئيسه أنه يعرف خوارزمية أسرع وراهن رئيسه بستة بنسات على أنه لم يعرفها. وافق رئيسه في النهاية على أنه خسر الرهان. في وقت لاحق، تعلم هور عن لغة ألغول للبرمجة وقدرته على القيام بالعودة التي مكنته من نشر الكود في مجلة علوم الاتصالات وآلات الحوسبة (بالإنجليزية: Communications of the Association for Computing Machinery)، وهي مجلة علوم الكمبيوتر الأولى في ذلك الوقت.
ومن جهة أخرى، تعتبر أطروحة الدكتوراه لروبرت سيدجويك في سنة 1975 علامة فارقة في دراسة فرز سريع حيث قام بحل الكثير من المشكلات المفتوحة المتعلقة بتحليل مخططات الاختيار المحوري المختلفة بما في ذلك العينات والتقسيم التكيفي بواسطة فان إمدن فضلًا عن اشتقاق العدد المتوقع المقارنات والمقايضات. قام جون بنتلي ودوغ ماكلروي بدمج تحسينات مختلفة للاستخدام في مكتبات البرمجة، بما في ذلك تقنية للتعامل مع العناصر المتساوية والمخطط المحوري المعروف باسم pseudomedian of تسعة، حيث يتم تقسيم عينة من تسعة عناصر إلى مجموعات من ثلاثة ثم متوسط يتم اختيار ثلاثة وسطاء من ثلاث مجموعات. وصف بنتلي مخطط تقسيم آخر أبسط ومضغوط في كتابه لآلئ البرمجة التي نسبها إلى نيكو لوموتو. كتب بنتلي لاحقًا أنه استعمل نسخة هور لسنوات لكنه لم يفهمها أبدًا، لكن نسخة لوموتو كانت بسيطة بما يكفي لإثبات صحتها. وصفت بنتلي فرز سريع بأنها «أجمل رمز كتبته على الإطلاق» في نفس المقال. تم كذلك تعميم مخطط تقسيم لوموتو من خلال مقدمة الكتاب المدرسي للخوارزميات على الرغم من أنه أدنى من مخطط هور لأنه يقوم وقت التشغيل عندما تكون جميع العناصر متساوية. ]
وفي هذا الصدد، اكتسب فرز سريع اعتمادًا واسع النطاق، حيث ظهر، مثلًا، في يونكس باعتباره روتين فرعي افتراضي لفرز المكتبة. ومن ثم، أعار اسمها إلى الروتين الفرعي للمكتبة القياسية C. وفي تنفيذ المرجع لجافا.
return j
قضايا التنفيذ
في هذا الإطار، swap A[i] with A[j]يتم تقريب التقسيم المحوري لأسفل، كما هو موضح هنا بواسطة دالة الأرضية؛ هذا يتجنب استخدام A [hi] كمحور، مما قد يؤدي إلى تكرار لا نهائي.
يتم فرز المجموعة بأكملها حسب .
فرز الجذر السريع
ومن جهة أخرى، تم تطويره كذلك بواسطة باورز باعتباره خوارزمية آلة الوصول العشوائي المتوازية هذا مرة أخرى عبارة عن مزيج من فرز الجذر والفرز السريع ولكن يتم اتخاذ قرار التقسيم السريع الفرز الأيسر / الأيمن على بتات متتالية من المفتاح، وبالتالي يكون -bit. تفترض جميع خوارزميات فرز المقارنة ضمنيًا النموذج متعدد التفرع مع في ، كما لو كانت أصغر، يمكننا الفرز في وقت باستخدام جدول التجزئة أو فرز عدد صحيح. إذا كانت ولكن العناصر فريدة داخل ، فلن يتم النظر إلى البتات المتبقية من خلال الفرز السريع أو الفرز الأساسي السريع. إذا تعذر ذلك، فإن جميع خوارزميات فرز المقارنة سيكون لها كذلك نفس النفقات العامة للبحث من خلال بتات عديمة الفائدة نسبيًا ولكن الفرز السريع للجذر سيتجنب أسوأ الخاصة بالفرز السريع القياسي والفرز السريع، وسيكون أسرع في أفضل حالة من خوارزميات المقارنة هذه في ظل ظروف راجع السلطات لمزيد من المناقشة حول النفقات العامة المخفية في المقارنة، والجذر والفرز المتوازي.
الفرز السريع متعدد المحاور
علاوةً على ذلك، بدلا من تقسيم إلى قسمين المصفوفات الفرعية باستخدام محور واحد، فرز سريع متعدد محور (كذلك متعدد فرز سريع ) تقسيم مدخلاته إلى بعض رقم من المصفوفات الفرعية باستخدام المحاور. في حين تم النظر في حالة المحور المزدوج بواسطة سيدجويك وآخرون بالفعل في منتصف السبعينيات، لم تكن الخوارزميات الناتجة أسرع في الممارسة العملية من الفرز السريع «الكلاسيكي». وجد تقييم عام 1999 لـ متعدد فرز سريع مع عدد متغير من المحاور، تم ضبطها لتحقيق الاستخدام الفعال لذاكرة التخزين المؤقت للمعالج، أنها تزيد من عدد التعليمات بحوالي 20٪، لكن نتائج المحاكاة تشير إلى أنها ستكون أكثر كفاءة مع المدخلات الكبيرة جدًا. هناك نسخة من التصنيف السريع ثنائي المحور طوره ياروسلافسكي في سنة 2009 تبين أنها سريعة بما يكفي لضمان التنفيذ في جافا 7، حيث أن الخوارزمية القياسية لفرز مصفوفات العناصر الأولية (يتم فرز مصفوفات الكائنات باستخدام تايمسورت). تم العثور لاحقًا على أن فائدة أداء هذه الخوارزمية مرتبطة في الغالب بأداء ذاكرة التخزين المؤقت، وتشير النتائج التجريبية إلى أن المتغير ثلاثي المحاور قد يؤدي بشكل أفضل على الأجهزة الحديثة.
swap A[i] with A[hi]
return iيتم فرز المجموعة بأكملها بواسطة .
if lo < hi then
- p := partition(A, lo, hi)
- quicksort(A, lo, p - 1)
- quicksort(A, p + 1, hi)
- algorithm partition(A, lo, hi) is
- pivot := A[hi]
- i := lo
- for j := lo to hi do
- if A[j] < pivot then
- swap A[i] with A[j]
- i := i + 1
التمحور القائم على الاختيار
كذلك، يختار أحد متغيرات التحديد السريع، وهو متوسط خوارزمية المتوسطات، المحاور بدقة أكبر، مما يضمن أن المحاور قريبة من منتصف البيانات (بين النسب المئوية 30 و 70)، وبالتالي تضمن الوقت الخطي - . يمكن استخدام نفس إستراتيجية المحور هذه لإنشاء متغير من الفرز السريع (متوسط الفرز السريع للوسيطات بوقت ومع ذلك، فإن النفقات العامة لاختيار المحور مهمة، لذلك لا يتم استخدام هذا بشكل عام في الممارسة.
من جهة ثانية، A اختيار خوارزمية يختار أصغر من قائمة بأرقام عشر. هذه مشكلة أسهل بشكل عام من الفرز. تعمل خوارزمية اختيار بسيطة ولكنها فعالة بنفس طريقة الفرز السريع على وجه التقريب، وبالتالي تُعرف باسم التحديد السريع. الفرق هو أنه بدلاً من إجراء مكالمات متكررة على كلتا القائمتين الفرعيتين، فإنه يقوم فقط بإجراء مكالمة متكررة ذيل واحدة في القائمة الفرعية التي تحتوي على العنصر المطلوب. يقلل هذا التغيير من متوسط التعقيد إلى الوقت الخطي أو ، وهو الأمثل للاختيار، لكن خوارزمية الفرز لا تزال .
المتغيرات
في هذا الإطار، بشكل أكثر تجريدًا، بالنظر إلى ، يمكن للمرء استخدامها للعثور على المحور المثالي (الوسيط) في كل خطوة من الفرز السريع، وبالتالي إنتاج خوارزمية فرز مع وقت تشغيل تكون التطبيقات العملية لهذا المتغير أبطأ إلى حد كبير في المتوسط، لكنها ذات أهمية نظرية لأنها تظهر أن خوارزمية اختيار مثالية يمكن أن تسفر عن خوارزمية فرز مثالية.
swap A[mid] with A[hi]
ومن جهة أخرى، pivot := A[hi]يضع الوسيط في A[hi] أولاً، ثم يتم استخدام القيمة الجديدة لـ A[hi] للمحور، كما هو الحال في الخوارزمية الأساسية المعروضة أعلاه.
وفي هذا الصدد، على وجه التحديد، العدد المتوقع من المقارنات اللازمة لفرز العناصر (انظر ) مع الاختيار المحوري العشوائي هو . يؤدي متوسط ثلاثة محاور إلى خفض هذا إلى ، على حساب زيادة قدرها ثلاثة بالمائة في العدد المتوقع من المقايضات. قاعدة تمحور أقوى، للمصفوفات الأكبر، هي اختيار التاسع، وهو متوسط تكراري من ثلاثة (Mo3)، كما هو محدد.
علاوةً على ذلك، يعد تحديد عنصر محوري أمرًا معقدًا كذلك بسبب وجود تجاوز عدد صحيح. إذا كانت مؤشرات الحدود للمصفوفة الفرعية التي يتم فرزها كبيرة بدرجة كافية، فإن التعبير الساذج للفهرس الأوسط، ، سيؤدي إلى تجاوز التدفق وتوفير فهرس محوري غير صالح. يمكن التغلب على ذلك باستخدام، مثلًا، لفهرسة العنصر الأوسط، على حساب حسابي أكثر تعقيدًا. تظهر مشكلات مماثلة في بعض الطرق الأخرى لاختيار العنصر المحوري.
ثلاث طرق فرز سريع للجذر
في هذا الإطار، هذه الخوارزمية عبارة عن مزيج من الفرز الأساسي والفرز السريع. اختر عنصرًا من المصفوفة (المحور) واعتبر الحرف الأول (المفتاح) من السلسلة (مالتيكاي). قسّم العناصر المتبقية إلى ثلاث مجموعات: تلك التي يكون حرفها المقابل أقل من، ويساوي، وأكبر من حرف المحور. قم بفرز الأقسام «أصغر من» و «أكبر من» بشكل متكرر على نفس الحرف. قم بفرز قسم «يساوي» بشكل متكرر حسب الحرف التالي (مفتاح). بالنظر إلى أننا نقوم بالفرز باستخدام البايتات أو الكلمات ذات الطول ، فإن أفضل حالة هي وأسوأ حالة أو على الأقل كما هو الحال بالنسبة للفرز السريع القياسي، المعطى للمفاتيح الفريدة و هو ثابت مخفي في جميع خوارزميات فرز المقارنة القياسية بما في ذلك الفرز السريع. هذا نوع من الفرز السريع ثلاثي الاتجاهات حيث يمثل القسم الأوسط مصفوفة فرعية مرتبة (تافهة) من العناصر التي تساوي تمامًا المحور.
عن التفضيلات والخوارزمية
من جهة ثانية، تنبني الخوارزمية على وضع العنصر الأول في المصفوفة (بإتخاذه محورًا), ثم فرز ووضع العناصر الأكبر من هذا المحور إلى جهة اليمنى من المصفوفة ووضع العناصر الأصغر في الجهة اليسرى. بهذه الطريقة يعتبر المحور في مكانه النهائي المرتّب. تسمى هذه العملية تجزئة ليتبقى من المصفوفة جزئين لم يتم ترتيبهما. نقوم لاحقًا بإعادة هذه الطريقة على الجزئين المتبقيين من المصفوفة وهكذا نحدد محورا جديدا ونعيد عملية التجزئة. تتكرر هذه العملية إلى أن نحصل على مجموعة مرتبة.
وفي هذا السياق، و بصفة عامة يعتبر الفرز السريع الأكثر شيوعا (شعبية) من بين جميع خوارزميات الترتيب.
ومن ناحية أخرى، في الناحية العملية، بالنسبة للتجزئات مع عدد قليل لا يتجاوز بضع عشرات من العناصر، يتم اللجوء عادة إلى الفرز بالإدراج الذي يكون أفضل من الفرز السريع.
كذلك، إذا تم اختيار المحور بطريقة صحيحة، نحصل على الطريقة الأسرع للفرز في الحالة المتوسطة، مع تعقيد ب. والتي قد تتحول إلى في الحالة الأصعب، وهي حالة جدول عناصره مرتبة أصلا. ولكن هذه الحالة بديهية لأن المجموعة مرتبة أصلا.
المشكلة الوحيدة تتمثل في كيفية اختيار المحور.
باستخدام التكرارات
ومن ناحية أخرى، طريقة بديلة هي إنشاء علاقة تكرار ، الوقت اللازم لفرز قائمة بالحجم . في أكثر الحالات غير المتوازنة، تتضمن مكالمة الفرز السريع الفردية العمل فضلًا عن مكالمتين متكررتين على قوائم الحجم و ، وبالتالي فإن علاقة التكرار هي
وفي السياق ذاته، يتبع مخطط إثبات رسمي لتعقيد الوقت المتوقع افترض أنه لا توجد نسخ مكررة حيث يمكن التعامل مع التكرارات بوقت خطي قبل المعالجة وبعدها، أو اعتبار الحالات أسهل من التي تم تحليلها. عندما يكون الإدخال عبارة عن تبديل عشوائي، فإن رتبة المحور تكون عشوائية منتظمة من 0 إلى . ثم يكون للأجزاء الناتجة من القسم أحجام و ، وأنا عشوائي منتظم من 0 إلى . لذلك، عند حساب المتوسط على جميع الانقسامات الممكنة مع ملاحظة أن عدد المقارنات للقسم هو ، يمكن تقدير متوسط عدد المقارنات عبر جميع تباديل تسلسل الإدخال بدقة عن طريق حل علاقة التكرار:
إضافةً إلى ذلك، هذه هي نفس العلاقة بالنسبة لفرز الإدراج وفرز التحديد، وهي تحل أسوأ حالة .
من جانب آخر، في الحالة الأكثر توازناً، تتضمن مكالمة الفرز السريع الفردية عمل إلى جانب مكالمتين متكررتين على قوائم بحجم ، وبالتالي فإن علاقة التكرار هي
ومن ناحية أخرى، هذا يعني أن الفرز السريع، في المتوسط، يؤدي فقط نحو 39٪ أسوأ مما كان عليه في أفضل حالاته. وبهذا المعنى، فهي أقرب إلى الحالة الأفضل من الحالة الأسوأ. لا يمكن لفرز المقارنة استخدام مقارنات أقل من في المتوسط لفرز العناصر (كما هو موضح في مقالة فرز المقارنة) وفي حالة الكبيرة، ينتج عن تقريب ستيرلينغ ، لذا فإن الفرز السريع ليس أسوأ بكثير من نوع المقارنة المثالي. يعد متوسط وقت التشغيل السريع هذا سببًا آخر للهيمنة العملية للفرز السريع على خوارزميات الفرز الأخرى.
يعطي حل التكرار .
تخبرنا النظرية الرئيسية لتكرار فرق تسد .
if lo < hi then
- p := partition(A, lo, hi)
- quicksort(A, lo, p)
- quicksort(A, p + 1, hi)
فرز سريع خارجي
من جهة ثانية، بالنسبة لملفات القرص، من الممكن إجراء فرز خارجي يعتمد على تقسيم مشابه للفرز السريع. إنه أبطأ من فرز الدمج الخارجي، لكنه لا يتطلب مساحة قرص إضافية. يتم استخدام 4 مخازن، 2 للإدخال، 2 للإخراج. دع N = عدد السجلات في الملف، B = عدد السجلات لكل مخزن مؤقت، و M = N / B = عدد مقاطع المخزن المؤقت في الملف. تتم قراءة البيانات (وكتابتها) من طرفي الملف إلى الداخل. دع X تمثل المقاطع التي تبدأ في بداية الملف وتمثل Y المقاطع التي تبدأ في نهاية الملف. تتم قراءة البيانات في المخازن المؤقتة للقراءة X و Y. يتم اختيار سجل محوري ويتم نسخ السجلات الموجودة في المخازن المؤقتة X و Y بخلاف السجل المحوري إلى المخزن المؤقت للكتابة X بفرز تصاعدي والمخزن المؤقت للكتابة Y بفرز تنازلي على أساس المقارنة مع السجل المحوري. بمجرد ملء المخزن المؤقت X أو Y، تتم كتابته في الملف ويتم قراءة المخزن المؤقت X أو Y التالي من الملف. تستمر العملية حتى تتم قراءة جميع المقاطع ويبقى مخزن مؤقت واحد للكتابة. إذا كان هذا المخزن المؤقت عبارة عن مخزن مؤقت للكتابة على شكل X، فسيتم إلحاق السجل المحوري به وكتابة المخزن المؤقت X. إذا كان هذا المخزن المؤقت عبارة عن مخزن مؤقت للكتابة على شكل Y، يتم إرسال السجل المحوري مسبقًا إلى المخزن المؤقت Y ويتم كتابة المخزن المؤقت Y. يشكل هذا خطوة قسم واحدة للملف، ويتكون الملف الآن من ملفين فرعيين. يتم دفع / ظهور مواضع البداية والنهاية لكل ملف فرعي إلى مكدس مستقل أو المكدس الرئيسي عبر العودية. لتقييد مساحة المكدس بـ O (log2 (n))، تتم معالجة الملف الفرعي الأصغر أولاً. بالنسبة للمكدس المستقل، ادفع معلمات الملف الفرعي الأكبر إلى المكدس، ثم كرر على الملف الفرعي الأصغر. للتكرار، كرر على الملف الفرعي الأصغر أولاً، ثم كرر للتعامل مع الملف الفرعي الأكبر. بمجرد أن يكون الملف الفرعي أقل من أو يساوي 4 سجلات B، يتم فرز الملف الفرعي في مكانه عبر الفرز السريع وكتابته. يتم الآن فرز هذا الملف الفرعي ووضعه في مكانه في الملف. تستمر العملية حتى يتم فرز جميع الملفات الفرعية ووضعها في مكانها الصحيح. متوسط عدد التمريرات على الملف هو على وجه التقريب 1 + ln (N + 1) / (4 B)، لكن نمط الحالة الأسوأ هو N عبر (ما يعادل O (n ^ 2) لأسوأ حالة فرز داخلي).
اختيار أفضل مؤشر
إضافةً إلى ذلك، عند استعمال الفرز السريع لمجموعة مرتبة مسبقا، وبطريقة اعتباطية، يستغرق كما قلنا وقتا كبيرا، وذلك راجع لأن أول عنصر هو الذي يعتبر محورا، الشيء الذي يؤدي إلى عدم تقسيم المجموعة إلى قسمين أكبر وأصغر من المحور. لحل المشكل يتم اختيار العنصر الأوسط، كما يمكن اختياره عشوائيا من عنصرين متواجدين حول المركز، حيث أن عملية اختيار المحور أو الأساس تحدد أداء الخوارزمية وتأرجحها بين وقت التشغيل N*Log n وN^2 بصيغة Big O Notation.
التحسينات
وفي السياق ذاته، عندما يكون عدد العناصر أقل من بعض العتبة (ربما عشرة عناصر)، قم بالتبديل إلى خوارزمية فرز غير متكررة مثل فرز الإدراج الذي يؤدي إلى مقايضات أو مقارنات أو عمليات أخرى على مثل هذه المصفوفات الصغيرة. ستختلف «العتبة» المثالية بناءً على تفاصيل التنفيذ المحدد.
وفي السياق ذاته، للتأكد من استخدام مساحة على الأكثر، قم بالتكرار أولاً في الجانب الأصغر من القسم، ثم استعمل استدعاء الذيل للتكرار في الجانب الآخر، أو قم بتحديث المعلمات بحيث لا تتضمن بعد الآن الجانب الأصغر المصنف الآن، وكرر لفرز الجانب الأكبر.
في هذا الإطار، هناك نوعان من التحسينات المهمة الأخرى، التي اقترحها سيدجويك والمستعملة على نطاق واسع في الممارسة، هي:
من جانب آخر، متغير أقدم من التحسين السابق: عندما يكون عدد العناصر أقل من الحد ، توقف ببساطة، ثم بعد معالجة المصفوفة بأكملها، قم بإجراء فرز للإدراج عليها. وقف الأوراق في وقت مبكر العودية -بفرز بالمجموعة، وهذا يعني أن كل عنصر في أغلب المناصب بعيدا عن موقفها النهائي فرزها. في هذه الحالة، يستغرق فرز لإنهاء الفرز، والذي يكون خطيًا إذا كان ثابتًا. مقارنة بتحسين «الكثير من الأنواع الصغيرة»، قد ينفذ هذا الإصدار تعليمات أقل، ولكنه يستعمل دون المستوى الأمثل لذاكرة التخزين المؤقت في أجهزة الكمبيوتر الحديثة.
algorithm partition(A, lo, hi) is
- pivot := A[ floor((hi + lo) / 2) ]
- i := lo - 1
- j := hi + 1
- loop forever
- do
- i := i + 1
- while A[i] < pivot do
- j := j - 1
- while A[j] > pivot
- if i ≥ j then
تحسينات أخرى
إضافةً إلى ذلك، عند استعمال الفرز السريع لفرز مجموعة ذات عناصر كبيرة، يمكن تغيير تقنية الفرز عند الوصول إلى مجموعة جزئية غير مرتبة عدد عناصرها صغير،10 أو أقل. الفرز بالاختيار مناسب في هذه الحالة.
كتلة الفرز السريع
من جانب آخر، في أي خوارزمية فرز قائمة على المقارنة، يتطلب تقليل عدد المقارنات تعظيم كمية المعلومات المكتسبة من كل مقارنة، مما يعني أن نتائج المقارنة غير متوقعة. يتسبب هذا في أخطاء متكررة في الفروع، مما يحد من الأداء. يقوم كتلة الفرز السريع بإعادة فرز حسابات التصنيف السريع لتحويل الفروع غير المتوقعة إلى تبعيات البيانات. عند التقسيم، يتم تقسيم الإدخال إلى كتل متوسطة الحجم (تتناسب بسهولة مع ذاكرة التخزين المؤقت للبيانات)، ويتم ملء صفيفين بمواضع العناصر المراد تبديلها. (لتجنب الفروع الشرطية، يتم تخزين الموضع دون قيد أو شرط في نهاية المصفوفة، ويزداد فهرس النهاية إذا كانت هناك حاجة إلى مبادلة.) يقوم التمرير الثاني بتبادل العناصر في المواضع المحددة في المصفوفات. تحتوي كلتا الحلقتين على فرع شرطي واحد فقط، وهو اختبار للإنهاء يتم إجراؤه عادةً.
i := lo // place for swapping
- for j := lo to hi – 1 do
- if A[j] ≤ pivot then
- swap A[i] with A[j]
- i := i + 1
- swap A[i] with A[hi]
return i
يتم فرز المصفوفة باستدعاء .
تحليل أفضل حالة
وعلى صعيد آخر، في الحالة الأكثر توازناً، في كل مرة نقوم فيها بإجراء قسم، نقسم القائمة إلى قسمين متساويين على وجه التقريب. هذا يعني أن كل مكالمة متكررة تعالج قائمة من نصف الحجم. ونتيجة لذلك، يمكننا أن نجعل فقط المتداخلة المكالمات قبل أن نصل إلى قائمة حجم 1. هذا يعني أن عمق شجرة الاستدعاء هو . لكن لا يوجد مكالمتان على نفس المستوى من شجرة الاستدعاء تعالج نفس الجزء من القائمة الأصلية ؛ وبالتالي، فإن كل مستوى من المكالمات يحتاج فقط إلى وقت معًا (كل مكالمة لها بعض الحمل الثابت، ولكن نظرًا لوجود في كل مستوى، يتم تضمين ذلك في عامل). والنتيجة هي أن الخوارزمية تستعمل الوقت فقط.
تحليل الحالة الأسوأ
وعلى صعيد آخر، إذا حدث هذا بشكل متكرر في كل قسم، فإن كل مكالمة متكررة تعالج قائمة بحجم أقل من القائمة السابقة. وبالتالي، يمكننا إجراء قبل أن نصل إلى قائمة الحجم 1. هذا يعني أن شجرة الاستدعاء عبارة عن سلسلة خطية من المكالمات المتداخلة عشر دعوة يفعل العمل للقيام به القسم، و ، وذلك في هذه الحالة فرز سريع يأخذ وقت
إضافةً إلى ذلك، يحدث القسم غير المتوازن عندما تكون إحدى القوائم الفرعية التي يتم إرجاعها بواسطة إجراء التقسيم بحجم . قد يحدث هذا إذا كان المحور هو أصغر أو أكبر عنصر في القائمة، أو في بعض عمليات التنفيذ (مثلًا، نظام تقسيم لوموتو كما هو موضح أعلاه) عندما تكون جميع العناصر متساوية.
مخطط تقسيم لوموتو
وعلى صعيد آخر، يُنسب هذا المخطط إلى نيكو لوموتو وشاعه بنتلي في كتابه برمجة بيرلز وكورمين وآخرون. في كتابهم مقدمة في الخوارزميات. يختار هذا النظام المحور الذي يكون عادةً العنصر الأخير في المصفوفة. الخوارزمية تحتفظ بالفهرس لأنه يمسح المصفوفة باستخدام فهرس آخر مثل أن العناصر الموجودة في خلال الصغرى (شامل) أقل من المحور والعناصر الموجودة في خلال (شاملة) تساوي أو أكبر من المحور. نظرًا لأن هذا المخطط أكثر إحكاما وسهل الفهم، فإنه يستعمل بشكل متكرر في المواد التمهيدية، على الرغم من أنه أقل كفاءة من مخطط هور الأصلي، مثلًا، عندما تكون جميع العناصر متساوية. يتحلل هذا المخطط إلى عندما تكون الصفيف في حالة جيدة بالفعل. كانت هناك متغيرات مختلفة مقترحة لتعزيز الأداء بما في ذلك طرق مختلفة لتحديد المحور، والتعامل مع العناصر المتساوية، واستخدام خوارزميات الفرز الأخرى مثل تصنيف الإدراج للمصفوفات الصغيرة وما إلى ذلك. في سودوكود، وهو تصنيف سريع يقوم بفرز العناصر في خلال الصغرى (شامل) للمصفوفة على النحو التالي:algorithm quicksort(A, lo, hi) is
التوازي
التحليل الرسمي
ومن ناحية أخرى، صيغة فرز سريع الخاصة بفرق تسد تجعلها قابلة للتوازي باستخدام توازي المهام. يتم إنجاز خطوة التقسيم من خلال استخدام خوارزمية مجموع البادئة المتوازية لحساب فهرس لكل عنصر مصفوفة في قسمها من المصفوفة المقسمة. بالنظر إلى مجموعة من الحجم ، تقوم خطوة التقسيم بتنفيذ العمل في الوقت وتتطلب مساحة خدش إضافية. بعد تقسيم المصفوفة، يمكن فرز القسمين بشكل متكرر على التوازي. المتوازي يفرز مجموعة من الحجم في تعمل في الوقت باستخدام مساحة إضافية.
علاوةً على ذلك، لدى فرز سريع بعض العيوب عند مقارنتها بخوارزميات الفرز البديلة، مثل دمج الفرز، مما يعقد موازنتها الفعالة. يؤثر عمق شجرة الانقسام والقهر في التصنيف السريع بشكل مباشر على قابلية توسيع الخوارزمية، ويعتمد هذا العمق إلى حدّ كبير على اختيار الخوارزمية للمحور. علاوةً على ذلك، من الصعب موازاة خطوة التقسيم بكفاءة في مكانها. يعمل استخدام مساحة التسويد على تبسيط خطوة التقسيم، ولكنه يزيد من أثر ذاكرة الخوارزمية والنفقات العامة الثابتة.
وفي هذا الصدد، يمكن أن تحقق خوارزميات الفرز المتوازي الأخرى الأكثر تعقيدًا حدودًا زمنية أفضل. مثلًا، في عام 1991، وصف ديفيد باورز الفرز السريع المتوازي (وفرز الجذر المرتبط) الذي يمكن أن يعمل في وقت على القراءة المتزامنة والكتابة المتزامنة (CRCW) وآلة الوصول العشوائي المتوازية (PRAM) مع معالجات بواسطة أداء التقسيم ضمنيًا.
اختيار المحور
من جهة ثانية، في الإصدارات المبكرة جدًا من الفرز السريع، غالبًا ما يتم اختيار العنصر الموجود في أقصى اليسار كعنصر محوري. لسوء الحظ، يتسبب هذا في سلوك أسوأ حالة على المصفوفات التي تم فرزها بالفعل، وهي حالة استخدام شائعة إلى حد ما. تم حل المشكلة بسهولة عن طريق اختيار إما فهرس عشوائي للمحور، أو اختيار المؤشر الأوسط للقسم أو (خاصة للأقسام الأطول) باختيار وسيط العنصر الأول والمتوسط والأخير من القسم للمحور (على النحو الموصى به من قبل عالم الكمبيوتر روبرت سيدجويك). تقاوم قاعدة «الوسيط من ثلاثة» حالة الإدخال المصنف (أو الفرز العكسي)، وتعطي تقديرًا أفضل للمحور الأمثل (الوسيط الحقيقي) بدلاً من تحديد أي عنصر فردي، في حالة عدم وجود معلومات حول فرز الإدخال معروف.
- مقتطف رمز متوسط من ثلاثة لقسم لوموتو:mid := ⌊(lo + hi) / 2
- ⌋ if A[mid] < A[lo]
- swap A[lo] with A[mid]
- if A[hi] < A[lo]
- swap A[lo] with A[hi]
- if A[mid] < A[hi]
أولا : نقوم باختيار المحور أو الأساس
إضافةً إلى ذلك، خامسا: نقوم بخطوة التجميع وهي تتصمن جمع المصوفات الثلاث في مصفوفة جديدة بفرز حيث نضع المصفوفة L ثم E ثم G فيصبح لدينا مصموفة
ومن جهة أخرى، ثانيا : نقوم بإنشاء ثلاث مصفوفات واحد G تحتوي على العناصر التي هي أكبر من المحور، الثانية E وهي تحتوي على عناصر التي هي مساوية
واحد فقط !
- تحتوي على العناصر مرتبة
- مثال
- algorithm فرز سريع (A, lo, hi) is
ثالثا : نقوم بعمل استدعاء ذاتي على المصفوفة L، G
ومن ناحية أخرى، رابعا : عند الوصول إلى مرحلة تكون فيها عدد العناصر في المصوفة اقل من 2 أي واحد تكون عناصر مصفوفة مرتبة لانها تحتوي على عنصر
وعلى صعيد آخر، للمحور، الثالثة وهي L وهي تحتوي على العناصر التي هي اقل من المحور
العلاقة بالخوارزميات الأخرى
وفي هذا السياق، المنافس المباشر للفرز السريع هو كومة. وقت تشغيل هيبسورت هو ، لكن متوسط وقت تشغيل هيبسورت يُعتبر عادةً أبطأ من الفرز السريع في المكان. هذه النتيجة قابلة للنقاش. تشير بعض المنشورات إلى عكس ذلك. إنتروسورت هو أحد أنواع الفرز السريع الذي يتحول إلى الفرز المتراكم عند اكتشاف حالة سيئة لتجنب وقت تشغيل الفرز السريع في أسوأ الحالات.
ومن جهة أخرى، فرز سريع هو نسخة محسّنة للمساحة لفرز الشجرة الثنائية. بدلاً من إدراج العناصر بشكل تسلسلي في شجرة صريحة، يقوم التصنيف السريع بتنظيمها بشكل متزامن في شجرة تتضمنها المكالمات المتكررة. تقوم الخوارزميات بإجراء نفس المقارنات تمامًا، ولكن بفرز مختلف. من الخصائص المرغوبة غالبًا لخوارزمية الفرز الاستقرار - حيث لا يتم تغيير فرز العناصر التي تقارن التساوي، مما يسمح بالتحكم في فرز جداول مالتيكاي (مثل قوائم الدليل أو المجلدات) بطريقة طبيعية. هذه المنشأة السياحية من الصعب الحفاظ عليها في الموقع فرز سريع (أو في مكان) (أي استخدامات فقط مساحة إضافية المستمر لمؤشرات ومخازن، مساحة إضافية لإدارة العودية الصريحة أو الضمنية). بالنسبة للفرز السريع المتغير الذي يتضمن ذاكرة إضافية بسبب التمثيلات باستخدام المؤشرات (مثل القوائم أو الأشجار) أو الملفات (القوائم الفعالة)، فمن التافه الحفاظ على الاستقرار. تميل هياكل البيانات الأكثر تعقيدًا أو المرتبطة بالقرص إلى زيادة تكلفة الوقت، مما يؤدي بشكل عام إلى زيادة استخدام الذاكرة الافتراضية أو القرص.
ومن ناحية أخرى، يعمل ميرجسورت بشكل جيد جدًا على القوائم المرتبطة، ولا يتطلب سوى قدر صغير وثابت من التخزين الإضافي. على الرغم من أنه يمكن تنفيذ الفرز السريع كنوع مستقر باستخدام القوائم المرتبطة، إلا أنه غالبًا ما يعاني من خيارات محورية ضعيفة بدون وصول عشوائي. يعد ميرجسورت كذلك الخوارزمية المفضلة للفرز الخارجي لمجموعات البيانات الكبيرة جدًا المخزنة على وسائط بطيئة الوصول مثل تخزين القرص أو التخزين المتصل بالشبكة.
كذلك، يتنافس فرز سريع كذلك مع فرز الدمج، وهو خوارزمية فرز يعد ميرجسورت نوعًا مستقرًا، على عكس الفرز السريع في المكان القياسي والفرز المتراكم، ويتميز بأداء ممتاز في أسوأ الحالات. العيب الرئيسي لفرز الدمج هو أنه عند التشغيل على المصفوفات، تتطلب التطبيقات الفعالة ، في حين أن متغير الفرز السريع مع التقسيم الموضعي والتكرار الخلفي يستعمل مساحة
من جهة ثانية، يشبه الفرز دلو مع دلاء إلى حد كبير الفرز السريع ؛ المحور في هذه الحالة هو بشكل فعال القيمة الموجودة في منتصف نطاق القيمة، والتي تعمل بشكل جيد في المتوسط للمدخلات الموزعة بشكل موحد.
if lo < hi then
- pp:= partition(A, lo, hi)
- فرز سريع (A, lo, p – 1)
- فرز سريع (A, p + 1, hi)
- algorithm partition(A, lo, hi) is
- pivot := A[hi]
استخدام شجرة بحث ثنائية
ننتهي بحساب قصير:
حسب خطية التوقع، القيمة المتوقعة من هو .
ومن ناحية أخرى، تتوافق شجرة البحث الثنائية التالية (BST) مع كل تنفيذ للفرز السريع: المحور الأولي هو العقدة الجذرية ؛ محور النصف الأيسر هو جذر الشجرة الفرعية اليسرى، ومحور النصف الأيمن هو جذر الشجرة الفرعية اليمنى، وهكذا. عدد مقارنات تنفيذ الفرز السريع يساوي عدد المقارنات أثناء إنشاء BST من خلال سلسلة من عمليات الإدراج. لذا، فإن متوسط عدد المقارنات للفرز السريع العشوائي يساوي متوسط تكلفة إنشاء BST عند إدراج القيم تشكيل تبديل عشوائي.
ومن جهة أخرى، ضع في اعتبارك BST تم إنشاؤه عن طريق إدراج تسلسل من القيم التي تشكل التقليب العشوائي. دع تشير إلى تكلفة إنشاء BST. نملك ، أين هو متغير عشوائي ثنائي يعبر عما إذا كان أثناء إدخال كانت هناك مقارنة .
وفي هذا الصدد، لاحظ ذلك منذ ذلك الحين هو تبديل عشوائي، هو كذلك تبديل عشوائي، لذا فإن الاحتمال مجاور ل هو بالضبط .
من جهة ثانية، إصلاح و . القيم بمجرد الفرز، حدد فترات الملاحظة الهيكلية الأساسية هي أن بالمقارنة مع في الخوارزمية إذا وفقط إذا يقع داخل أحد الفترتين المتجاورتين لـ .
عناصر متكررة
علاوةً على ذلك، باستخدام خوارزمية التقسيم مثل مخطط تقسيم لوموتو الموضح أعلاه (حتى إذا كان يختار قيمًا محورية جيدة)، يُظهر الفرز السريع أداءً ضعيفًا للمدخلات التي تحتوي على الكثير من العناصر المتكررة. تظهر المشكلة بوضوح عندما تكون جميع عناصر الإدخال متساوية: في كل تكرار، يكون القسم الأيسر فارغًا (لا توجد قيم إدخال أقل من المحور)، ويكون القسم الأيمن قد انخفض بمقدار عنصر واحد فقط (تتم إزالة المحور). وبالتالي، فإن مخطط تقسيم لوموتو يأخذ الوقت من الدرجة الثانية لفرز مجموعة من القيم متساوية. ومع ذلك، باستخدام خوارزمية التقسيم مثل نظام تقسيم هور، تؤدي العناصر المتكررة عمومًا إلى تقسيم أفضل، وعلى الرغم من إمكانية حدوث مبادلات غير ضرورية للعناصر المساوية للمحور، فإن وقت التشغيل ينخفض بشكل عام مع زيادة عدد العناصر المتكررة (مع ذاكرة التخزين المؤقت تقليل حجم المبادلة). في حالة تساوي جميع العناصر، يقوم مخطط تقسيم هور بتبديل العناصر دون داع، ولكن التقسيم نفسه هو أفضل حالة، كما هو مذكور في قسم قسم هور أعلاه.
وفي السياق ذاته، لحل مشكلة مخطط تقسيم لوموتو (تسمى أحيانًا مشكلة العلم الوطني الهولندي )، يمكن استخدام روتين بديل لتقسيم الوقت الخطي يفصل القيم إلى ثلاث مجموعات: القيم الأقل من المحور، والقيم التي تساوي المحور، والقيم الأكبر من المحور. (يسمي بنتلي وماكلروي هذا «قسمًا سمينًا» وقد تم تنفيذه بالفعل في من الإصدار 7 يونكس.) القيم التي تساوي المحور تم فرزها بالفعل، لذا يجب فرز الأقسام الأصغر من والأكبر من فقط بشكل متكرر. في الكود الزائف، تصبح خوارزمية الفرز السريعalgorithm quicksort(A, lo, hi) is
تعميم
مراجع
علاوةً على ذلك، اكتشف ريتشارد جيه كول وديفيد سي. قندثيل، في سنة 2004، عائلة مكونة من معلمة واحدة من خوارزميات الفرز، تسمى أنواع الأقسام، والتي تعمل في المتوسط (مع احتمالية متساوية لجميع أوامر الإدخال) على الأكثر مقارنات (قريبة من الحد الأدنى النظري للمعلومات) و عمليات؛ في أسوأ الأحوال يؤدونها المقارنات (وكذلك العمليات)؛ هذه في مكانها، وتتطلب إضافية فقط الفراغ. تم إثبات الكفاءة العملية والتباين الأصغر في الأداء مقابل الأنواع السريعة المحسّنة (لسيارات سيدجويك وجون بنتلي - دوغلاس ماكلروي).
باستخدام النسب المئوية
ومن ناحية أخرى، عندما يكون الإدخال تبديلًا عشوائيًا، يكون للمحور فرز عشوائي، وبالتالي لا يمكن ضمان أن يكون في منتصف 50 بالمائة. ومع ذلك، عندما نبدأ من التقليب العشوائي، في كل استدعاء تكراري، يكون للمحور فرز عشوائي في قائمته، وبالتالي فهو في منتصف 50 بالمائة على وجه التقريب نصف الوقت. هذا جيد بما فيه الكفاية. تخيل أن عملة انقلبت: الرؤوس تعني أن رتبة المحور في منتصف 50 بالمائة، والذيل يعني أنه ليس كذلك. تخيل الآن أن العملة انقلبت مرارًا وتكرارًا حتى تحصل على شكل . على الرغم من أن هذا قد يستغرق وقتًا طويلاً، إلا أنه في المتوسط فقط، واحتمال عدم حصول العملة المعدنية على رؤوس أمر غير محتمل للغاية (يمكن جعل هذا صارمًا باستخدام حدود تشيرنوف). من خلال نفس الوسيطة، سينتهي عودية فرز سريع في المتوسط عند عمق مكالمة فقط . ولكن إذا كان متوسط عمق المكالمة هو ، وكل مستوى من عمليات شجرة الاستدعاء في أغلب العناصر، فإن إجمالي مقدار العمل المنجز في المتوسط هو المنتج . لا يتعين على الخوارزمية التحقق من أن المحور يقع في النصف الأوسط - إذا ضربناه بأي جزء ثابت من المرات، فهذا يكفي للتعقيد المطلوب.
من جهة ثانية، إذا كان لكل محور مرتبة في مكان ما في منتصف 50 بالمائة، أي بين 25 بالمائة و 75 بالمائة، فإنه يقسم العناصر بنسبة 25٪ على الأقل و 75٪ على الأكثر على كل جانب. إذا تمكنا من اختيار هذه المحاور باستمرار، فسنضطر فقط إلى تقسيم القائمة على الأكثر مرات قبل الوصول إلى قوائم الحجم 1، مما ينتج عنه خوارزمية
if lo < hi then
left, right := partition(A, p, lo,
p := pivot(A, lo, hi)
hi) // note: multiple return values
في هذا الإطار، quicksort(A, right + 1, hi)يقوم partition بإرجاع المؤشرات إلى العنصر الأول («أقصى اليسار») وإلى العنصر الأخير («أقصى اليمين») من القسم الأوسط. كل عنصر من القسم يساوي p وبالتالي يتم فرزها. وبالتالي، لا يلزم تضمين عناصر القسم في الاستدعاءات المتكررة فرز سريع .
علاوةً على ذلك، تحدث أفضل حالة للخوارزمية الآن عندما تكون جميع العناصر متساوية (أو يتم اختيارها من مجموعة صغيرة من ). في حالة كل العناصر المتساوية، سينفذ التصنيف السريع المعدل مكالمتين متتاليتين فقط على المصفوفات الفرعية الفارغة، وبالتالي ينتهي في الوقت الخطي (بافتراض أن partition الفرعي لا يستغرق أكثر من الوقت الخطي).
quicksort(A, lo, left - 1)
فرز سريع جزئي وتزايدي
في هذا الإطار، توجد الكثير من المتغيرات من الفرز السريع التي تفصل العناصر الأصغر أو الأكبر
الخوارزمية
وفي السياق ذاته، الحالة الأساسية للتكرار هي مصفوفات بحجم صفر أو واحد، وهي مرتبة حسب التعريف، لذلك لا تحتاج أبدًا إلى الفرز.
علاوةً على ذلك، يمكن إجراء خطوات التحديد والتقسيم المحوري بعدة طرق مختلفة؛ يؤثر اختيار مخططات التنفيذ المحددة بدرجة كبيرة على أداء الخوارزمية.
من جانب آخر، التقسيم : أعد فرز المصفوفة بحيث تأتي جميع العناصر ذات القيم الأقل من المحور قبل المحور، بينما تأتي جميع العناصر ذات القيم الأكبر من المحور بعده (يمكن أن تذهب القيم المتساوية في أي اتجاه). بعد هذا التقسيم، يكون المحور في موضعه النهائي. هذا يسمى عملية التقسيم .
من جانب آخر، قم بتطبيق الخطوات المذكورة أعلاه بشكل متكرر على المصفوفة الفرعية للعناصر ذات القيم الأصغر وبشكل منفصل على المصفوفة الفرعية للعناصر ذات القيم الأكبر.
وعلى صعيد آخر، فرز سريع هي خوارزمية فرق تسد. يقوم أولاً بتقسيم مصفوفة الإدخال إلى مصفوفتين فرعيتين أصغر: العناصر المنخفضة والعناصر العالية. ثم يقوم بفرز المصفوفات الفرعية بشكل متكرر. خطوات الترتيب السريع الموضعي هي:
اختر عنصرًا يسمى المحور من المصفوفة.
تحليل متوسط الحالة
وفي هذا الصدد، لفرز مجموعة من العناصر المتميزة في التوقع، بمتوسط كل تباديل عناصر باحتمالية متساوية. نسرد هنا ثلاثة أدلة شائعة لهذا الادعاء تقدم رؤى مختلفة حول طريقة عمل الفرز السريع.
تعقيد الفضاء
ملخص خطوات الخوارزمية
كذلك، يحتوي الإصدار الموضعي من الفرز السريع على تعقيد مساحة ، حتى في أسوأ الحالات، عندما يتم تنفيذه بعناية باستخدام الاستراتيجيات التالية:
من جهة ثانية، فرز سريع مع التقسيم الموضعي وغير المستقر يستعمل مساحة إضافية ثابتة فقط قبل إجراء أي مكالمة متكررة. يجب أن يقوم فرز سريع بتخزين قدر ثابت من المعلومات لكل مكالمة متكررة متداخلة. نظرًا لأن أفضل حالة تجعل على الأكثر استدعاءات متكررة متداخلة ، فإنها تستعمل مساحة ومع ذلك، من دون حيلة سيدجويك للحد من المكالمات متكررة، في أسوأ حالة فرز سريع يمكن أن تجعل دعوات متكررة متداخلة والحاجة الفضاء مساعدة.
ومن ناحية أخرى، المساحة التي يستعملها الفرز السريع تعتمد على الإصدار المستعمل.
في هذا الإطار، إصدار آخر، أقل شيوعًا، غير موجود، من الفرز السريع يستعمل لتخزين العمل ويمكنه تنفيذ فرز مستقر. تسمح مساحة التخزين العاملة بتقسيم مصفوفة الإدخال بسهولة بطريقة مستقرة ثم نسخها مرة أخرى إلى مصفوفة الإدخال لإجراء مكالمات متكررة متتالية. لا يزال تحسين روبرت سيدجويك مناسبًا.
وفي هذا الصدد، يتم استخدام التقسيم الموضعي. يتطلب هذا القسم غير المستقر مساحة
في هذا الإطار، من وجهة نظر التعقيد قليلاً، لا تستعمل المتغيرات مثل lo و hi مساحة ثابتة ؛ يستغرق الأمر bits للفهرسة في قائمة من العناصر. نظرًا لوجود مثل هذه المتغيرات في كل إطار مكدس، فإن الفرز السريع باستخدام خدعة وبرت سيدجويك يتطلب بت من المساحة. متطلبات المساحة هذه ليست سيئة للغاية، على الرغم من ذلك، لأنه إذا كانت القائمة تحتوي على عناصر مميزة، فستحتاج على الأقل إلى بت من المساحة.
وفي السياق ذاته، بعد التقسيم، يتم فرز القسم الذي يحتوي على أقل عدد من العناصر (بشكل متكرر) أولاً، مما يتطلب مساحة ثم يتم فرز القسم الآخر باستخدام تكرار الذيل أو التكرار، والذي لا يضيف إلى مكدس الاستدعاءات. هذه الفكرة، كما تمت مناقشتها أعلاه، وصفها روبرت سيدجويك، وتحافظ على عمق المكدس المحدد بـ .
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟