محول مولد مسبق التدريب
المحتويات
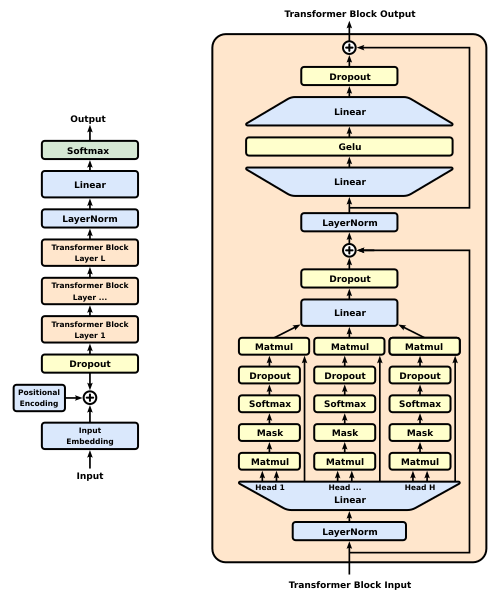
تعريفًا بالموضوع، المُحول المُولّد مسبق التدريب (جي بي تي) أو المحول المُولّد المدرب مسبقا (بالإنجليزية: Generative pre-trained transformers (GPT)) هي نوع من النماذج اللغوية الكبيرة وإطار بارز للذكاء الاصطناعي التوليدي. قدمت شركة أوبن أيه آي الجي بي تي الأول في عام 2018. نماذج الجي بي تي هي شبكات عصبية اصطناعية تعتمد على هيكلية محولات، مدربة مسبقا على مجموعات بيانات كبيرة من النصوص غير الموسومة، وقادرة على توليد محتوى جديد يشبه المحتوى البشري. أصبحت لأغلب النماذج اللغوية الكبيرة بحلول عام 2023 هذه الخصائص وتشار إليها أحيانا على نطاق واسع بصفتها جي بي تيز . وفيما يلي تفاصيل أوسع عن ذلك.
ومن ناحية أخرى، يُستعمل مصطلح "جي بي تي" كذلك في أسماء وأوصاف النماذج التي طورها الآخرون. مثلًا، تشمل النماذج الأساسية الأخرى لـ جي بي تي سلسلة من النماذج التي أنشأتها إي لوثر إي آي، ومؤخراً سبعة نماذج أنشأتها في 2023. فضلًا عن ذلك، قامت شركات في صناعات مختلفة بتطوير جي بي تيز محددة للمهام في مجالاتها المختلفة، مثل نموذج سيلز فورس المُسمى "أينشتاين جي بي تي - " (لإدارة علاقات العملاء)، ونموذج بلومبيرغ المُسمى "برومبيرج جي بي تي - " (للتمويل).
التاريخ
وفي هذا الصدد، أصدرت أوبن أيه آي نماذج أساسية لـ جي بي تي ذات تأثير كبير والتي رُقمت بتسلسل، لتشكل سلسلتها جي بي تي-إن . كل من هذه النماذج كان أكثر قدرة من السابق، بسبب الحجم المتزايد (عدد المعاملات التي يمكن تدريبها) والتدريب. أحدث هذه النماذج، جي بي تي-4، أُصدر في مارس 2023. هذه النماذج كانت الأساس لأنظمة جي بي تي الخاصة بهذه النماذج المخصصة للمهام الأكثر تحديدًا، بما في ذلك النماذج المعدلة لمتابعة الإرشادات - التي بدورها تُشغل خدمة الدردشةشات جي بي تي.
قضايا العلامة التجارية
المُحول المُولِّد مسبق التدريب 5
علاوةً على ذلك، وبشكل مُتصل، تقدمت أوبن أيه آي إلى مكتب الولايات المتحدة لبراءات الاختراع والعلامات التجارية (USPTO) للحصول على تسجيل علامة تجارية محلية لمُصطلح "جي بي تي - GPT" في مجال الذكاء الاصطناعي. سعت أوبن أيه آي إلى تسريع معالجة طلبها، لكن مكتب البراءات رفض هذا الطلب في أبريل 2023. في مايو 2023 رد مكتب البراءات على الطلب بتحديد أن "جي بي تي" كان وصفًا عامًا. اعتبارًا من نوفمبر 2023، تُواصل أوبن أيه آي مُتابعة حجتها من خلال العمليات المُتاحة. بغض النظر عن ذلك، فإن عدم الحصول على علامة تجارية أمريكية مُسجلة لا يحول دون مستوى مُعين من حقوق العلامات التجارية بموجب القانون العام في الولايات المتحدة، و/أو حقوق العلامات التجارية في دول أخرى.
انظر كذلك
من جانب آخر، أكدت شركة أوبن أيه آي، التي أنشأت أول محول توليدي مُدرّب مُسبقًا (GPT) في سنة 2018، مؤخرًا أنه يجب اعتبار "جي بي تي" علامة تجارية خاصة بها. وفي أبريل 2023 عدلت إرشادات العلامة التجارية في الخاصة بها للإشارة إلى أن الشركات الأخرى التي تستعمل واجهة برمجة التطبيقات الخاصة بها لتشغيل خدمات الذكاء الاصطناعي الخاصة بها لن تتمكن بعد الآن من تضمين "جي بي تي" في مثل هذه الأسماء أو العلامات التجارية. في مايو 2023 تعاقدت أوبن أيه آي مع خدمة إدارة العلامات التجارية لإخطار عملاء واجهة برمجة التطبيقات الخاصة بها بهذه السياسة، على الرغم من أن هذه الإخطارات لم تصل إلى حد تقديم مُطالبات قانونية علنية (مثل مزاعم أو ). في نوفمبر 2023 بدأت في تمكين مُشتركي "شات جي بي تي بلس" من إنشاء إصدارات مُخصصة من "شات جي بي تي" والتي تُسمى "جي بي تيز - GPTs" على موقع أوبن أيه آي. تنص شروط خدمة أوبن أيه آي على أنه يجوز لمُشتركيها استخدام "جي بي تي" في أسماء هذه الإصدارات، على الرغم من أنه "غير مُشجع".
وفي هذا الصدد، تُشير تقارير أخرى إلى أنه من غير المرجح منح تسجيلًا للعلامة التجارية "GPT وحده، نظرًا للاستخدام المتكرر للمصطلح للإشارة ببساطة إلى أنظمة الذكاء الاصطناعي التي تنطوي على المحولات التوليدية المدربة مسبقًا. وفي كل الأحوال سيحتاج الآخرون إلى تجنب استخدام المصطلح لمنتجات أو خدمات مُماثلة بطرق يُحتمل أن تُسبب ارتباكًا. لكن إذا أصبحت هذه الحقوق واسعة النطاق بما يكفي لتوريط استخدامات أخرى راسخة في هذا المجال، فإن مبدأ الاستخدام العادل الوصفي للعلامات التجارية لا يزال يُمكن أن يُواصل الاستخدام غير المُتعلق بالعلامة التجارية.
ومن ناحية أخرى، بالنسبة لأي نوع أو نطاق من حماية العلامات التجارية في الولايات المتحدة، ستحتاج أوبن أيه آي إلى إثبات أن المصطلح "مُميز" بالفعل لعروضها المُحددة إلى جانب كونه مُصطلحًا تقنيًا أوسع لنوع التكنولوجيا. أشارت بعض التقارير الإعلامية إلى أن أوبن أيه آي قد تتمكن من الحصول على تسجيل علامة تجارية بشكل غير مُباشر بناءً على شهرة منتج روبوت الدردشة "شات جي بي تي"، الذي سعت أوبن أيه آي للحصول على حماية له بشكل مُنفصل وسعت لفرضه بقوة أكبر.
النماذج المخصصة للمهام
من جهة ثانية، نوع آخر من المهام التي يُمكن استخدام جي بي تي من أجلها هو المهمة الفوقية المتمثلة في إنشاء تعليماته الخاصة، مثل تطوير سلسلة من المُطالبات "لنفسها" لتكون قادرة على تحقيق هدف أكثر عمومية يُحدده مُستعمل بشري. يُعرف هذا باسم وكيل الذكاء الاصطناعي، وبشكل أكثر تحديدًا وكيل تكراري لأنه يستعمل نتائج تعليماته الذاتية السابقة لمساعدته في تشكيل مُطالباته اللاحقة؛ كان المثال الرئيسي الأول على ذلك هو أوتو جي بي تي (الذي يستعمل نماذج جي بي تي من أوبن أيه آي)، ومنذ ذلك الحين طُورت نماذج أخرى كذلك.
وعلى صعيد آخر، يمكن تكييف نموذج جي بي تي الأساسي بشكل أكبر لإنتاج أنظمة أكثر استهدافًا موجهة إلى مهام مُحددة و/أو مجالات موضوعية. يمكن أن تتضمن أساليب هذا التكييف ضبطًا دقيقًا إضافيًا (إلى جانب ما يُجرى للنموذج الأساسي) فضلًا عن أشكال مُعينة من هندسة المُطالبات.
وعلى صعيد آخر، من الأمثلة المهمة على ذلك ضبط النماذج بدقة لاتباع التعليمات، وهي بالطبع مهمة واسعة إلى حد ما ولكنها أكثر استهدافًا من النموذج الأساسي. في يناير 2022، قدمت أوبن أيه آي "انستركت جي بي تي - " - وهي سلسلة من النماذج التي ضُبطت بدقة لاتباع التعليمات باستخدام مزيج من التدريب المُراقب والتعلم المعزز من التغذية الراجعة البشرية (RLHF) على نماذج لغة جي بي تي-3 الأساسية. تشمل المزايا التي يتمتع بها هذا على النماذج الأساسية المجردة دقة أعلى، ومشاعر سلبية/سامة أقل، ومحاذاة أفضل بشكل عام مع احتياجات المستعمل. لذلك، بدأت أوبن أيه آي في استخدام هذا كأساس لعروض خدمة واجهة برمجة التطبيقات الخاصة بها. تم إصدار نماذج أخرى مُضبوطة للتعليمات من قبل آخرين، بما في ذلك إصدار مفتوح بالكامل.
وفي السياق ذاته، نوع آخر (ذو صلة) من النماذج المُخصصة للمهام هو روبوتات الدردشة، التي تُشارك في محادثة تُشبه الإنسان. في نوفمبر 2022 أطلقت أوبن أيه آي "شات جي بي تي" - وهي واجهة دردشة عبر الإنترنت تعمل بواسطة نموذج لغة مُضبوط للتعليمات دُرب بطريقة مُشابهة لـ "انستركت جي بي تي". قاموا بتدريب هذا النموذج باستخدام التعلم المعزز من التغذية الراجعة البشرية، حيث يُجري مُدربو الذكاء الاصطناعي البشري محادثات يلعبون فيها دور كل من المستعمل والذكاء الاصطناعي، وخلطوا مجموعة بيانات الحوار الجديدة هذه مع مجموعة بيانات "انستركت جي بي تي" للحصول على تنسيق محادثة مُناسب لروبوت الدردشة. تشمل روبوتات الدردشة الرئيسية الأخرى في الوقت الحالي بينغ شات من مايكروسوفت، الذي يستعمل جي بي تي-4 من أوبن أيه آي (كجزء من تعاون وثيق أوسع بين أوبن أيه آي ومايكروسوفت)، وروبوت الدردشة المُنافس من جوجل، بارد الذي أعتمد في البداية على عائلة لامدا من نماذج اللغات المُدربة على المحادثة، مع خطط لتحويله إلى نماذج بالم.
التطورات اللاحقة
في هذا الإطار، في مارس 2022، نشرت أوبن أيه آي إصدارين من جي بي تي-3 ضُبطا بدقة لاتباع التعليمات (ضبط التعليمات)، ويُسمى (175 مليار) ونموذج "دافنشي النصي الأول - "، ثم بدأت اختبار بيتا لنموذج "كود دافنشي الثاني - ". [33] ضُبط نموذج "دافنشي النصي الثاني" لاتباع التعليمات من نموذج "كود دافنشي الثاني". في نوفمبر 2022 أصدرت الشركة نموذجي "دافنشي النصي الثالث - " وشات جي بي تي، وكلاهما مبني على "دافنشي النصي الثاني" عبر التعلم المعزز من التغذية الراجعة البشرية (RLHF). دُرب نموذج "دافنشي النصي الثالث" على اتباع التعليمات (مثل سابقاتها)، بينما دُرب "شات جي بي تي" بشكل أكبر على التفاعل الحواري مع مُستعمل بشري.
من جهة ثانية، أصدرت شركة أوبن أيه آي نموذج جي بي تي-4 وهو أحدث نموذج جي بي تي أساسي في 14 مارس 2023. وأتاحت للمستعملين الوصول إليه مُباشرةً من خلال إصدار مُميز من "شات جي بي تي"، وأتاحت للمطورين دمجه في المنتجات والخدمات الأخرى عبر واجهة برمجة التطبيقات. من بين المُنتجين الآخرين لنماذج جي بي تي الأساسية شركة "إليوثير أيه آي" ولها سلسلة من النماذج بدأت إصدارها في مارس 2021، وشركة "سيريبراس" ولها سبعة نماذج بدأت اصدارها في مارس 2023.
في هذا الإطار، في يوليو 2021، نشرت أوبن أيه آي نموذج "كوديكس - "، وهو نموذج جي بي تي مُخصص للمهام مُستهدف لتطبيقات البرمجة. طُور عن طريق الضبط الدقيق لإصدار 12 مليار مُعلمة من جي بي تي-3 (يختلف عن نماذج جي بي تي-3 السابقة) باستخدام التعليمات البرمجية من غيت هاب.
وفي السياق ذاته، نشرت أوبن أيه آي الإصدارات الأولى من جي بي تي-3 في يوليو 2020. وكانت له ثلاثة نماذج: باباج بواقع 1 مليار مُعلمة، وكوري - بواقع 6.7 مليار مُعلمة، ودافنشي - بواقع 175 مليار مُعلمة.
تخصص المجال
كذلك، BloombergGPT - للمجال المالي، للمساعدة في الأخبار والمعلومات المالية (يستعمل أساليب الذكاء الاصطناعي "المُتاحة مجانًا"، جنبًا إلى جنب مع بياناتهم الخاصة).
ومن ناحية أخرى، في بعض الأحيان، تُحقق خصوصية المجال عبر المكونات الإضافية للبرامج أو الإضافات. مثلًا، طورت الكثير من الشركات المختلفة مكونات إضافية مُعينة تتفاعل مُباشرةً مع واجهة "شات جي بي تي" من أوبن أيه آي، ولدى جوجل ورك سبيس إضافات مُتاحة مثل والتي يُقال إنها تُساعد في استخدام وظائف جداول البيانات في جداول بيانات جوجل.
من جهة ثانية، في نوفمبر 2023، أعلنت أوبن أيه آي أنها ستُتيح لمُشتركي "شات جي بي تي بلس" إنشاء إصدارات مُخصصة من "شات جي بي تي" تُسمى "جي بي تيز - ". بحيث يُمكن تخصيصها لمجالات مُحددة عبر هندسة المُطالبات، ومجموعات البيانات المُنسقة، والتفاعل المُستهدف مع الأدوات الخارجية. ويمكن للمستعملين الذين يُسجلون كمُنشئين مُتحققين إتاحة الـ "جي بي تيز" للمستعملين آخرين، مع إمكانية تحقيق الدخل منها. (هذا يختلف بشكل ملحوظ عن خدمة واجهة برمجة تطبيقات أوبن أيه آي، حيث يعتمد هذا داخليًا على منصة أوبن أيه آي.)
من جانب آخر، SlackGPT - لخدمة المراسلة الفورية سلاك، للمساعدة في التنقل وتلخيص المُناقشات عليها (يستعمل واجهة برمجة تطبيقات أوبن أيه آي).
وفي هذا السياق، EinsteinGPT - لمجالات المبيعات والتسويق، للمساعدة في إدارة علاقات العملاء (يستعمل جي بي تي-3.5).
وفي هذا السياق، BioGPT - للمجال الطبي الحيوي، للمساعدة في توليد النصوص واستخراج البيانات من الأدبيات الطبية الحيوية (يستعمل جي بي تي-2).
من جانب آخر، يمكن توجيه أنظمة جي بي تي نحو مجالات أو نطاقات مُعينة. فيما يلي بعض الأمثلة لهذه النماذج والتطبيقات:
إضافةً إلى ذلك، Khanmigo - يُوصف بأنه إصدار جي بي تي للتدريس، يُساعد الطلاب الذين يستعملون أكاديمية خان من خلال إرشادهم خلال دراساتهم دون تقديم إجابات مُباشرة (مدعوم من جي بي تي-4).
تعددية الوسائط
إضافةً إلى ذلك، يمكن كذلك استهداف الأنظمة التوليدية القائمة على المحولات للمهام التي تتضمن أساليب تتجاوز النص. مثلًا يجمع "شات جي بي تي المرئي" من مايكروسوفت بين "شات جي بي تي" ونماذج الرؤية الأساسية (VFMs) لتمكين الإدخال أو الإخراج الذي يشتمل على صور إلى جانب نص. كذلك تُوفر التطورات في تقنية تحويل النص إلى كلام أدوات لإنشاء محتوى صوتي عند استخدامها جنبًا إلى جنب مع نماذج لغة جي بي تي الأساسية.
النماذج الأساسية
كذلك، يمكن أن تستعمل النماذج الأساسية أنماطًا أخرى غير النصوص كمدخلات أو مخرجات. ويعد نموذج جي بي تي-4 نموذجًا متعدد الوسائط له القدرة على مُعالجة المدخلات كنص أو صورة، وتقتصر مخرجاته على النصوص. فيما يتعلق بالإخراج متعدد الوسائط، تُستعمل بعض النماذج التوليدية القائمة على المحولات لتقنيات في تقنيات تحويل النص إلى صورة، مثل نماذج الانتشار وفك التشفير المتوازي. يمكن أن تكون هذه الأنواع من النماذج بمثابة نماذج أساسية مرئية (VFMs) لتطوير أنظمة لاحقة يُمكنها العمل مع الصور.
علاوةً على ذلك، تُعتبر هذه النماذج الأساسية الأكثر بروزًا في سلسلة نماذج "جي بي تي" من أوبن أيه آي، وأحدثها هو جي بي تي-4 الذي رفضت أوبن أيه آي نشر حجم النموذج أو تفاصيل تدريبه مشيرة إلى "البيئة التنافسية والآثار الأمنية للنماذج الكبيرة".
في هذا الإطار، النموذج الأساسي هو نموذج ذكاء اصطناعي دُرب على بيانات واسعة النطاق ويمكن تكييفه لمجموعة متنوعة من المهام اللاحقة.
إضافةً إلى ذلك، من النماذج الأخرى نموذج بالم من جوجل، وهو نموذج أساسي شامل يُقارن بجي بي تي-3، وهو متاح للمطورين عبر واجهة برمجة التطبيقات (API)، ونموذج "جي بي تي-جي تي - " من توقيذر، والذي يُعتبره البعض أقرب بديل مفتوح المصدر لجي بي تي-3 وهو مشتق من نماذج جي بي تي مفتوحة المصدر السابقة. كما أن لدى "ميتا أيه آي" (المعروفة سابقًا باسم فيسبوك) نموذجًا كبيرًا قائمًا على التحويلات التوليدية، يُعرف باسم لاما.
قائمة المراجع المُختارة
WebGPT: إعلان في مدونة، تقرير،
من جهة ثانية، فيما يلي قائمة بالإصدارات الرسمية الرئيسية من "أوبن أيه آي"، ومايكروسوفت حول نماذج GPT الخاصة بهم:
- GPT-1: تقرير، إصدار على GitHub.
- GPT-2: إعلان في مدونة، تقرير حول قرار الإصدار "المتدرج"، إصدار على GitHub.
- GPT-3: تقرير. لم يتم إصدار الكود على GitHub أو بأي صيغة أخرى منذ ذلك الحين.
- InstructGPT: إعلان في مدونة، تقرير.
- ChatGPT: إعلان في مدونة (لا يوجد تقرير).
- GPT-4: إعلان في مدونة، تقارير، بطاقة نموذج.
- GPT-4o: إعلان في مدونة.
- المصادر
التطورات الأولية
إضافةً إلى ذلك، في سنة 2017 عمل بعض المؤلفين الذين سيعملون لاحقًا على جي بي تي-1 على التدريب التوليدي المسبق للغة باستخدام الذاكرة القصيرة المدى المطولة (LSTM)، مما أدى إلى نموذج يُمكنه تمثيل النص باستخدام متجهات يُمكن ضبطها بسهولة للتطبيقات اللاحقة.
وفي هذا الصدد، قبل البنى القائمة على المحولات، كانت نماذج البرمجة اللغوية العصبية (معالجة اللغة الطبيعية) الأفضل أداءً تستعمل التعلم المُراقب من كميات كبيرة من البيانات المُعلّمة يدويًا. حد الاعتماد على التعلم المُراقب من استخدامها في مجموعات البيانات التي لم تكن مُعلّمة جيدًا، كما جعل تدريب نماذج اللغات الكبيرة للغاية مُكلفًا ويستغرق وقتًا طويلاً بشكل باهظ.
إضافةً إلى ذلك، خلال العقد الثاني من القرن الحادي والعشرين، حلت الشبكات العصبية المتكررة مشكلة الترجمة الآلية مع إضافة آلية الانتباه. تم تحسين ذلك في بنية المحولات، التي نشرها باحثو جوجل في "الانتباه هو كل ما تحتاجه" (2017). أدى هذا التطور إلى ظهور نماذج لغوية كبيرة مثل BERT في 2018. الذي كان عبارة عن محول مُدرّب مُسبقًا (PT) ولكن لم يتم تصميمه ليكون توليديًا (كان BERT نموذجًا "للتشفير فقط"). كذلك في عام 2018 نشرت أوبن أيه آي "تحسين فهم اللغة من خلال التدريب التوليدي المسبق"، والذي قدم نموذج جي بي تي-1 وهو أول نماذج سلسلة جي بي تي.
وعلى صعيد آخر، كان التدريب التوليدي المسبق (GP) مفهومًا راسخًا منذ فترة طويلة في تطبيقات التعلم الآلي. وكان يُستعمل أساسًا كشكل من أشكال التعلم شبه المُراقب، حيث يُدرب النموذج على مجموعة بيانات غير مُعلّمة (خطوة التدريب المسبق) من خلال تعلم توليد نقاط البيانات في مجموعة البيانات، ثم يُدرب على تصنيف مجموعة بيانات مُعلّمة. وكانت هناك 3 أنواع رئيسية من التدريب التوليدي المُبكر.
وفي هذا السياق، تضمن النهج شبه المُراقب الذي استعملته أوبن أيه آي لإنشاء نظام توليدي واسع النطاق - وكان أول من فعل ذلك باستخدام نموذج محول - مرحلتين: مرحلة "تدريب مُسبق" توليديةغير مُراقبة لتعيين المعلمات الأولية باستخدام هدف نمذجة اللغة، ومرحلة "ضبط دقيق" تمييزية مُراقبة لتكييف هذه المعلمات مع مهمة مُستهدفة.
علاوةً على ذلك، تتعلم نماذج ماركوف المخفية نموذجًا توليديًا للتسلسلات للتطبيقات اللاحقة. مثلًا، في التعرف على الكلام، يستنتج نموذج ماركوف المخفي المُدرب التسلسل المخفي الأكثر احتمالية لإشارة الكلام، ويُؤخذ التسلسل المخفي على أنه أصوات إشارة الكلام. طُورت هذه النماذج في السبعينيات وطُبقت في التعرف على الكلام في الثمانينيات.
علاوةً على ذلك، تتعلم أدوات الضغط ضغط البيانات مثل الصور والتسلسلات النصية، وتُعتبر البيانات المضغوطة تمثيلًا جيدًا للتطبيقات اللاحقة مثل التعرف على الوجه. وبالمثل تتعلم أجهزة التشفير التلقائي تمثيلًا كامنًا للبيانات لتطبيقات لاحقة مثل التعرف على الكلام. لُوحظت العلاقة بين أجهزة التشفير التلقائي وأدوات الضغط الخوارزمية في سنة 1993.
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟