مصرف (حوسبة)
المحتويات
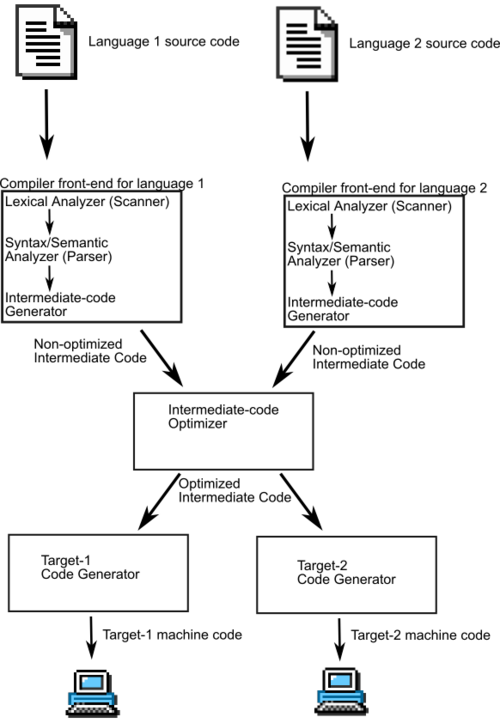
في البداية، المُصرِّف أو البَرنامَج المُترجِم أو المُترجِم أو برنَامَج الترجَمة أو البَرنامَج المُؤلِّف هو برنامج حاسوبي يُحوّل الملفات المصدرية إلى أوامر مباشرة يفهمها الحاسوب وينفذها مباشرة بما يناسب بنية الحاسوب الذي يستهدفه البرنامج. وتعرض الأقسام التالية جوانب أخرى من الموضوع.
ومن جهة أخرى، البرامج المكتوبة بلغات عالية المستوى تكون في الغالب أقصر من البرامج المناظرة لها والمكتوبة بلغة الآلة.
إضافةً إلى ذلك، على غير البدايات، حين كانت البرامج تُبرمج أصلًا بلغات منخفضة المستوى (أي قريبة من بِنية الحاسوب) يفهمها الحاسوب مباشرة، أصبحت الآن البرامج تبرمج بلغات عالية المستوى (عالية أي بعيدة عن فهم الحاسوب لها، وأقرب إلى فهم البشر)؛ لأن البرامج زادت في تعقيدها وفي حساباتها، مما جعل البرمجة المباشرة للحاسوب أمرًا صعبًا، وانتشار عدة بِنى للحاسوب (مثل آرم وx64 وx86) جعل من اللازم كتابة البرامج عدة مرات بلغات ذات مستويات متدنية عدة لكي تعمل على عدة حواسيب مختلفة. لمواجهة هذا ظهرت لغات برمجة عالية المستوى تركز على المهم من الأمور في البرمجة وتسهل من إدارة المشاريع البرمجية، وتجعل استهداف عدة أجهزة ممكنًا بملف مصدري واحد مهما تعددت البِنى (مع مراعاة بعض التفاصيل الصغيرة عند ذلك وضبطها).
علاوةً على ذلك، من ناحية أخرى فان البرامج المكتوبة بلغة برمجة عالية المستوى تُترجَم تلقائيًا إلى لغة الآلة ربما تُنفّذ ببطء أكثر مما لو كتبت بلغة الآلة مباشرة. ومن هنا فإن بعض البرامج التي يُعد عامل الوقت والسرعة في التنفيذ مهم جدا بالنسبة لها ما زالت تكتب بلغة الآلة، ومع ذلك فإن المترجم الجيد يمكنه أن يصل بسرعة البرامج المكتوبة بلغة عالية المستوى إلى نفس سرعة تنفيذ البرامج المناظرة لها والمكتوبة بلغة الآلة إذا عمل الكثير من التحسينات الجيدة وكانت البرامج المكتوبة باللغة عالية المستوى مكتوبة بشكل جيد ومنظم.
وفي السياق ذاته، بالمقارنة بلغة الآلة، فإن شكل لغات البرمجة عالية المستوى أقرب لطريقة تفكير الإنسان في حل المشكلات.
والأسباب الرئيسة لذلك هي:
وفي هذا السياق، مِيزة أخرى في استخدام لغات البرمجة عالية المستوى أن نفس البرنامج المكتوب بها يمكن ترجمته إلى أنواع كثيرة من لغات الآلة لذا يمكن نقله إلى منصات كثيرة وأنواع كثيرة من الحواسيب.
يستطيع المترجم معرفة الأخطاء الواضحة في أثناء البرمجة.
حجز المسجلات
ومن جهة أخرى، أسماء المتغيرات الرمزية المستعملة في الكود الوسيط تُترجَم إلى أعداد كل من هذه الأعداد يرمز إلى مسجل في لغة الآلة.
مرحلة إنتاج الكود الوسيط
من جهة ثانية، تُترجم البرنامج إلى لغة وسيطة مستقلة عن تركيبة الحاسب الداخلية.
التحليل اللغوي
if (a == b)
في هذا الإطار، في هذه المرحلة يُقرَأ الكود المصدري ويُقسَّم إلى مجموعة من الرموز (Tokens)، كل رمز يمثل عنصر من عناصر لغة البرمجة مثلًا، (كلمة محجوزة أو اسم متغير أو عدد أو رمز... إلخ).
مثلًا، إذا كان الكود المصدري بهذا الشكل:
a++;
- وبعد مروره بهذه المرحلة يُحَوَّل إلى هذا الشكل:
- if ------- كلمة مفتاحية
- ------- مسافة فارغة
- ( ------- رمز
- a ------- اسم متغير
- ------- مسافة فارغة
- ------- رمز
- ------- مسافة فارغة
- b ------- اسم متغير
- ) ------- رمز
- ------- مسافة فارغة
- a ------- اسم متغير
- ++ ------- رمز
- ; ------- رمز
مراحل المترجم
وفي هذا الصدد، هناك تقسيم شائع ومعروف لهذه المراحل، ولكن ترتيب هذه المراحل قد يختلف قليلًا من مترجم إلى آخر، فبعض هذه المراحل قد تُجمَّع وبعضها قد تُقسَّم إلى مراحلَ أصغر.
وفي هذا السياق، تُنفَّذ هذه المراحل تسلسليًا، وإن كان ذلك لا يعني بالضرورة تنفيذًا بهذا الشكل في أثناء تصميم المترجم فبعض هذه المراحل تتداخل مع بعضها.
ومن جهة أخرى، كل مرحلة (ما عدا الأولى) تأخذ مخرجات المرحلة التي تسبقها مُدخلاتًا لها، ومن الشائع أن نجعل كل مرحلة وحدةً مستقلة؛ فبعض هذه الوحدات تُكتَب باليد والبعض الآخر تُنشَأ عن طريق مواصفات أو معايير مواصفة.
ومن ناحية أخرى، لأن كتابة المترجمات ليست عملية سهلة على الإطلاق فإنه من الأفضل أن نقسم طريقة بناء المترجم، والوسيلة التقليدية لذلك هي في أن نقسم عملية الترجمة إلى عدة مراحل.
إنتاج كود لغة الآلة
علاوةً على ذلك، اللغة الوسيطة تُترجَم إلى لغة الأسمبلي (وهي شكل نصي للغة الآلة) لنوع معين من تركيبة الحاسب (X86 أو Power PC).
التحليل النحوي أو القواعدي
إضافةً إلى ذلك، هذه المرحلة تأخذ مجموعة الtokens التي تم إنتاجها في مرحلة التحليل اللغوي وترتبهم في شكل شجرة (تعرف بشجرة القواعد Syntax tree) والتي تشير إلى تركيب البرامج وتسمى هذه المرحلة كذلك بمرحلة التجزئة.
التجميع والربط
ومن جهة أخرى، كل مرحلة، من مراحل الفحص والتحويل تؤسس أشكال ثابتة قوية للأشياء التي تمرر للمراحل التالية لذا فان كتابة كل مرحلة على حِدَةٍ أسهل.
ومن جهة أخرى، لغة الاسمبلي تُترجَم إلى الترميز الثنائي وتُحدَّد عناوين المتغيرات، الدوال...الخ
وفي هذا السياق، أخطاء النوع. يتم التجميع والربط ببرامج تُوفَّر بواسطة نظام التشغيل وهي ليست جزء من المترجم نفسه.
من جانب آخر، الجزء الوسيط فقط للمترجم في هذا السياق هو مرحلة إنتاج الكود الوسيط وهي مرحلة تشمل غالبا الكثير من التحسينات والتحويلات على الكود الوسيط.
كذلك، المراحل الثلاث الأولى مجتمعة تسمى الـFront End للمترجم والمراحل الثلاث الأخرى تسمى Backend للمترجم
علاوةً على ذلك، مثلًا فاحص النوع type checker يمكنه أن يفترض غياب الأخطاء القواعدية ومرحلة إنتاج الكود تفترض غياب ا
فحص النوع
من جهة ثانية، هذه المرحلة تحلل شجرة القواعد لكي تحدد ما إذا كان البرنامج يتجاوز متطلبات سلامة معينة (مثلا متغير تم استخدامه لكن لم يُعلَن عنه أو تم استخدامه في سياق لا يعترف به).
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟