معالج (حوسبة)
المحتويات
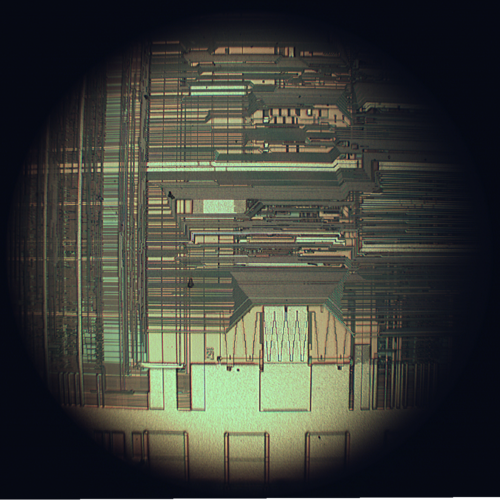
على سبيل التعريف، وحدة المعالجة المركزية (، وتختصر إلى CPU)، أو المُعالج ، هي أحدى مكونات عتاد الحاسوب التي تقوم بتفسير التعليمات ومعالجة البيانات التي تتضمنها البرامج. يُعتبر المعالج فضلًا عن الذاكرة الرئيسية ووحدات الإدخال والإخراج من أهم مكونات الحواسيب الدقيقة الحديثة. تُعرف المعالجات التي صنعت باستخدام الدوائر المتكاملة بالمعالجات الدقيقة. يمثل هذا النوع من المعالجات الغالبية العظمى من المعالجات المستعملة اليوم. يُنظر إلى وحدة المعالجة المركزية على أنها "عقل" الحاسوب. وفيما يلي تفاصيل أوسع عن ذلك.
ومن ناحية أخرى، يُستعمل مصطلح "المعالج" بشكل متكرر للإشارة إلى وحدة المعالجة المركزية، وهي المعالج الرئيسي في النظام . ومع ذلك، يمكن أن يشير المصطلح كذلك إلى ، مثل وحدة المعالجة الرسومية ، أو حتى الدوائر المنطقية المصممة لمعالجة أنواع معينة من البيانات (مثل معالجات الإشارات الرقمية).
آلية عمل المعالج
ومن جهة أخرى، فك التشفير (Decode): تقوم وحدة التحكم بتحليل التعليمة التي تم جلبها لتحديد العملية المطلوب تنفيذها (مثل الجمع، النقل، القفز) والمعاملات (Operands) التي ستُستعمل في العملية (قد تكون قيمًا فورية، أو عناوين سجلات، أو عناوين ذاكرة) [المقالة_2: operations][المقالة_3: 5]. يتم تحديد طريقة تفسير قيمة التعليمة بواسطة مجموعة تعليمات المعالج (ISA) [المقالة_2: c]. في بعض المعالجات، يتم استخدام برنامج صغير داخلي يسمى "الرمز الميكروي (Microcode)" لترجمة التعليمات المعقدة إلى عمليات أبسط [المقالة_2: decode].
علاوةً على ذلك، التنفيذ (Execute): يتم تنفيذ العملية المحددة بواسطة التعليمة. قد يشمل ذلك إرسال المعاملات إلى وحدة الحساب والمنطق (ALU) لإجراء عملية حسابية أو منطقية، أو تغيير قيمة عداد البرنامج (في حالة تعليمات القفز أو التفرع)، أو الوصول إلى الذاكرة [المقالة_2: operations][المقالة_3: 5]. غالبًا ما يتم تحديث سجل الحالة (الأعلام) بناءً على نتيجة التنفيذ [المقالة_2: writeback][المقالة_3: 5].
وعلى صعيد آخر، بعد اكتمال هذه الدورة، يتكرر العملية للتعليمة التالية التي يشير إليها عداد البرنامج [المقالة_2: writeback]. في المعالجات الحديثة، غالبًا ما تتداخل هذه المراحل باستخدام تقنية خط الأنابيب (Pipelining) وتنفيذ التعليمات خارج الترتيب (Out-of-order execution) لتحقيق أداء أعلى [المقالة_2: writeback][المقالة_3: 10].
ومن ناحية أخرى، يتبع عمل المعالج دورة أساسية لتنفيذ كل تعليمة في البرنامج، تُعرف بدورة الجلب-فك التشفير-التنفيذ (Fetch-Decode-Execute Cycle)، وغالبًا ما تتضمن خطوة رابعة هي كتابة النتيجة (Writeback) [المقالة_2: operations].
وفي السياق ذاته، جلب المعاملات (Fetch Operands): إذا كانت التعليمة تتطلب بيانات من الذاكرة أو السجلات، يتم جلب هذه البيانات (المعاملات) في هذه المرحلة [المقالة_3: 5].
كذلك، كتابة النتيجة (Writeback): يتم كتابة نتيجة العملية (إذا كانت هناك نتيجة) إلى سجل أو موقع في الذاكرة [المقالة_2: operations].
وفي السياق ذاته، الجلب (Fetch): تقوم وحدة التحكم بجلب (قراءة) التعليمة التالية من الذاكرة (عادةً من الذاكرة المخبئية L1). يتم تحديد عنوان التعليمة بواسطة عداد البرنامج (PC) [المقالة_2: operations][المقالة_3: 5]. بعد جلب التعليمة، يتم عادةً زيادة قيمة عداد البرنامج ليشير إلى التعليمة التالية [المقالة_2: operations].
إشارة الساعة
من جهة ثانية، تضم أغلب المعالجات إشارة الساعة (Clock Signal) وهى دوائر منطقية تتابعية (sequential logic) تعمل بشكل متزامن، أي أنها تتبع إيقاع إشارة الساعة. وهي إشارة كهربائية دورية غالبًا ما تكون موجة مربعة، تحدد وتيرة تنفيذ العمليات . يجب أن تكون فترة الساعة أطول من أقصى زمن انتشار للإشارة داخل المعالج لضمان التشغيل الصحيح. زيادة تردد الساعة تزيد من سرعة المعالج ولكنها تزيد كذلك من استهلاك الطاقة وتوليد الحرارة، وتطرح تحديات في الحفاظ على تزامن الإشارة عبر الرقاقة.
تقنيات زيادة الأداء
وفي السياق ذاته، المعالجة المتعددة المتماثلة (Symmetric Multiprocessing - SMP): يشير إلى نظام كمبيوتر يحتوي على معالجين فيزيائيين أو أكثر (كل منهم قد يكون متعدد النوى)، يتشاركون جميعًا في نفس الذاكرة الرئيسية ويديرهم نسخة واحدة من نظام التشغيل [المقالة_2: tlp].
ومن جهة أخرى، تهدف هذه التقنيات إلى تنفيذ خيوط معالجة (Threads) متعددة بشكل متزامن، حيث يمثل كل خيط سلسلة مستقلة من التعليمات (قد تكون جزءًا من نفس البرنامج أو برامج مختلفة) [المقالة_2: ilp_tlp].
كذلك، خيوط المعالجة المتزامنة (Simultaneous Multithreading - SMT): تسمح لنواة معالج واحدة (بمعمارية فائقة القياس) بتنفيذ تعليمات من خيوط معالجة متعددة في نفس دورة الساعة، باستخدام وحدات التنفيذ المتاحة بشكل أكثر كفاءة [المقالة_2: tlp]. بالنسبة لنظام التشغيل، تظهر كل نواة فيزيائية تدعم SMT كأنها نواتان (أو أكثر) منطقيتان. مثال شهير هو تقنية Hyper-Threading من إنتل [المقالة_3: 4.1].
من جانب آخر، خط الأنابيب (Pipelining): هي التقنية الأساسية لـ ILP. تقسم عملية تنفيذ التعليمة (جلب، فك تشفير، تنفيذ، كتابة) إلى مراحل منفصلة تعمل عليها أجزاء مختلفة من المعالج بشكل متزامن، مثل خط التجميع. يسمح هذا ببدء تنفيذ تعليمة جديدة في كل دورة ساعة (في الحالة المثالية)، حتى لو كانت كل تعليمة تستغرق عدة دورات لإكمالها [المقالة_2: pipeline].
وفي السياق ذاته، المعالجات متعددة النوى (Multi-core Processors): تحتوي هذه المعالجات على نواتين أو أكثر من نوى المعالجة المستقلة (كل نواة لها وحدة تحكم و ALU خاصة بها) على نفس الرقاقة [المقالة_2: multicore][المقالة_3: 4.1]. يمكن لكل نواة تنفيذ خيط معالجة مختلف بشكل مستقل وبالتوازي مع النوى الأخرى. تتشارك النوى عادةً في بعض الموارد مثل الذاكرة المخبئية من المستوى الأعلى (L3) والوصول إلى الذاكرة الرئيسية [المقالة_3: 4.5].
من جانب آخر، المعمارية فائقة القياس (Superscalar Architecture): تتضمن وجود وحدات تنفيذ متعددة (مثل وحدات ALU أو FPU متعددة) داخل نواة المعالج [المقالة_2: 19]. يمكن للمعالج جلب وفك تشفير وإرسال (dispatch) تعليمات متعددة في كل دورة ساعة إلى وحدات التنفيذ هذه، بشرط عدم وجود تبعيات بينها [المقالة_2: superscalar].
ومن جهة أخرى، التنفيذ التكهني (Speculative Execution): غالبًا ما تستعمل مع التنبؤ بالتفرع. يقوم المعالج بتخمين المسار الذي سيسلكه البرنامج عند تفرع شرطي ويبدأ في تنفيذ التعليمات في ذلك المسار "تكهنيًا" قبل التأكد من صحة التخمين. إذا كان التخمين صحيحًا، يتم توفير الوقت؛ وإذا كان خاطئًا، يتم التخلص من النتائج التكهنية والبدء في تنفيذ المسار الصحيح [المقالة_2: superscalar].
في هذا الإطار، الوصول غير الموحد للذاكرة (Non-Uniform Memory Access - NUMA): بنية للأنظمة متعددة المعالجات حيث يكون لكل معالج (أو مجموعة معالجات) ذاكرة محلية خاصة به، فضلًا عن القدرة على الوصول إلى ذاكرة المعالجات الأخرى (ولكن بزمن وصول أطول). تُستعمل في الأنظمة الكبيرة جدًا لتحسين قابلية التوسع [المقالة_2: tlp].
ومن جهة أخرى، التنفيذ خارج الترتيب (Out-of-Order Execution - OoOE): تسمح هذه التقنية للمعالج بتغيير ترتيب تنفيذ التعليمات عن الترتيب الأصلي في البرنامج. إذا كانت تعليمة ما متوقفة، يمكن للمعالج تنفيذ تعليمات لاحقة لا تعتمد عليها، ثم يعيد ترتيب النتائج لاحقًا لضمان صحة البرنامج [المقالة_3: 5][المقالة_3: 10].
في هذا الإطار، التوازي على مستوى التعليمات (Instruction-Level Parallelism - ILP)
ومن ناحية أخرى، تهدف هذه التقنيات إلى تنفيذ أكثر من تعليمة واحدة في نفس الوقت أو زيادة معدل تنفيذ التعليمات داخل نواة معالج واحدة [المقالة_2: ilp_tlp].
كذلك، لمواجهة الطلب المتزايد على الأداء، تم تطوير الكثير من التقنيات لزيادة سرعة وكفاءة المعالجات، والتي تندرج غالبًا تحت مفهوم التوازي (Parallelism).
علاوةً على ذلك، التوازي على مستوى خيوط المعالجة والمعالجات متعددة النوى (Thread-Level Parallelism - TLP)
البنية الأساسية ووحدات التشغيل
وفي هذا الصدد، احدى اهم مكونات نوي المعالج، المسجلات ، وهي وحدات ذاكرة صغيرة وعالية السرعة داخل المعالج تُستعمل لتخزين البيانات والتعليمات وعناوين الذاكرة مؤقتًا أثناء المعالجة، حيث انه يوجد مسجلات اساسية مدمجة بالنوي، مثل المراكم ، والذي يقوم بتخزين نتائج العمليات الحسابية والمنطقية، وعداد البرنامج ، والذي يحتوي على عنوان الذاكرة للتعليمة التالية المراد تنفيذها. وسجل التعليمة ، والذي يخزن التعليمة التي يتم تنفيذها في الوقت الحالي. و أو سجل الأعلام ، والذي يحتوي على بتات أو أعلام ، حيث تُشير إلى حالة نتائج العمليات الأخيرة، مثل هل النتيجة صفر، سالبة، وجود حمل أو ترحيل.
وفي هذا السياق، يتكون لب أو نوي المعالج من عدة مكونات أساسية تعمل معًا لتنفيذ التعليمات، حيث يعتبر أهمها وحدة التحكم أو الموجه ، والذي يدير وينسق عمليات المعالج. يقوم كذلك بفك تشفير التعليمات الواردة من الذاكرة، وتحديد السجلات المطلوبة، وتنشيط الدوائر اللازمة لتنفيذ التعليمات. غالبًا ما يحتوي كذلك على سجل التعليمة لتخزين التعليمة الحالية، وعداد البرنامج لتتبع عنوان التعليمة التالية. كما أنه يتولى إدارة المقاطعات .
كذلك، يحتوي كذلك لب أو نوي المعالج على وحدة الحساب والمنطق ، وهي الوحدة المسؤولة عن إجراء العمليات الحسابية، مثل الجمع والطرح والعمليات المنطقية، مثل بوابة العطف ، بوابة الفصل ، العاكس .
إضافةً إلى ذلك، يضم المعالج بداخله عدة مسجلات، من أهمها ، والذي يشير إلى قمة منطقة الذاكرة المسماة المكدس ، والتي تستعمل غالبًا لإدارة استدعاءات الدوال وتخزين المتغيرات المحلية. والمسجلات العامة ، والتى تُستعمل لتخزين البيانات التي سيتم استخدامها قريباً، مما يقلل الحاجة للوصول المتكرر إلى الذاكرة الرئيسية الأبطأ.
النواقل والمسرى
وفي هذا الصدد، تعد النواقل أو المسرى إحدى اهم مكونات المعالج والحاسوب عموماً، وهى مجموعة من الأسلاك أو المسارات الكهربائية التي تربط وتنقل البيانات بين مكونات المعالج المختلفة ومع المكونات الخارجية مثل ذاكرة الوصول العشوائي، مثلا ناقل البيانات ومهمته نقل البيانات بين المعالج والذاكرة أو وحدات الإدخال والإخراج، أو مثل ، والذى يكون مسئول عن حمل عناوين الذاكرة التي يريد المعالج الوصول إليها للقراءة أو الكتابة، او ، والذى يحمل إشارات التحكم التي تُدير تدفق البيانات والعمليات مثل إشارات القراءة والكتابة، وإشارة المقاطعة.
التطور التاريخي
ومن ناحية أخرى، تعود جذور المعالجات الحديثة إلى الأعمال النظرية لـجون فون نيومان في الأربعينيات، والتي هدفت إلى التغلب على صعوبات إعادة برمجة الآلات الحاسبة المبكرة مثل إنياك ، حيث كان تغيير البرنامج يتطلب إعادة توصيل الأسلاك يدويًا. وصفت المعمارية التي وصفها جون فون نيومان، والتي تضمنت وحدة تحكم تنسق عمل المعالج والذاكرة والمدخلات والمخرجات، في وثيقة بعنوان "المسودة الأولى لتقرير عن ".
وعلى صعيد آخر، قبل عصر الترانزستور، كانت المعالجات تُبنى باستخدام مكونات ضخمة مثل الصمامات المفرغة ، أو المرحلات ، كما في حاسوب زد 3 لـكونراد سوزه عام 1941 والذي استعمل 600 مرحل لوحدة الحساب والمنطق و 1400 مرحل للذاكرة. كانت هذه الأجهزة تشغل غرفًا بأكملها، تستهلك طاقة كبيرة، وتولد حرارة هائلة، وكانت عرضة للأعطال. كان حاسوب إنياك، الذي استعمل 18000 صمام مفرغ و 1500 مرحل، مثالًا بارزًا على هذه الحقبة.
علاوةً على ذلك، استمر هذا التطور بدمج مكونات إضافية داخل المعالج الرئيسي، مثل المعالج المساعد الرياضي والذي يدعي وحدة الفاصلة العائمة او اختصارا بـ في أواخر الثمانينيات، أو وحدة المعالجة الرسومية في أواخر العقد الأول من القرن الحادي والعشرين أو مثل وحدة تسريع المعالجة .
ومن جهة أخرى، شهدت أوائل السبعينيات ظهور المعالج الدقيق ، الذي يدمج جميع وظائف المعالج في رقاقة واحدة. كان إنتل 4004 (عام 1971) أول معالج دقيق، تلاه إنتل 8080 (عام 1974) الذي أصبح شائع الاستخدام. أدى هذا الابتكار إلى استبدال شبه كامل للطرق السابقة لبناء وحدات المعالجة المركزية. أدى التصغير والتوحيد القياسي إلى زيادة كبيرة في سرعات المعالجات، حيث ارتفعت ترددات التشغيل من بضعة ميجا هيرتز إلى عدة جيجا هرتز.
وفي هذا الصدد، كانت المعالجات الأولى تُصمم خصيصًا لنوع معين من أجهزة الكمبيوتر، وهي عملية مكلفة. أدى السعي نحو التكلفة المنخفضة والإنتاج الضخم إلى تطوير معالجات قياسية يمكن استخدامها في تطبيقات متعددة. بدأ هذا الاتجاه في الحواسيب المركزية والحواسيب الصغيرة القائمة على الترانزستورات المنفصلة، وتسارع إلى حدّ كبير مع ظهور الدوائر المتكاملة.
وعلى صعيد آخر، شكل اختراع الترانزستور في سنة 1947 نقطة تحول، حيث مهد الطريق لتصغير المكونات الإلكترونية بدرجة كبيرة. في الخمسينيات، حلت الترانزستورات محل الصمامات المفرغة غير الموثوقة، مما قلل من استهلاك الطاقة وحجم الحواسيب. في البداية، تم بناء المعالجات من ترانزستورات فردية، ولكن مع تطور تقنية الدوائر المتكاملة ، تم دمج المزيد والمزيد من وظائف الترانزستور على رقائق صغيرة.
المواد الجديدة والاتجاهات المستقبلية
ومن ناحية أخرى، التغليف المتقدم: تقنيات مثل تكديس الرقائق (Chip Stacking) لدمج الذاكرة والمعالجات بشكل أقرب لتحسين عرض النطاق الترددي وتقليل زمن الوصول [المقالة_2: multicore].
من جهة ثانية، لمواجهة تحديات تصغير السيليكون، يستكشف الباحثون مواد وتقنيات جديدة للمعالجات المستقبلية:
ألماس: يُبحث في خصائصه لتطبيقات المعالجات [المقالة_1: 11].
المواد البديلة للسيليكون:
إضافةً إلى ذلك، أنابيب نانوية كربونية: تم بناء معالجات دقيقة تجريبية باستخدام ترانزستورات أنابيب الكربون النانوية [المقالة_1: 9].
كذلك، حوسبة غير متجانسة: دمج أنواع مختلفة من النوى والمعالجات المتخصصة (CPU, GPU, NPU, DSP) على نفس الرقاقة (System-on-a-Chip - SoC) لتحسين الأداء والكفاءة لمجموعة واسعة من المهام.
وفي هذا الصدد، حوسبة كمومية: كما ذكر سابقًا، تستعمل الكيوبتات لإجراء أنواع معينة من الحسابات بشكل أسرع بكثير من الحواسيب الكلاسيكية [المقالة_1: 14][المقالة_1: 15].
وفي هذا الصدد، حوسبة ضوئية: استخدام الضوء بدلاً من الإلكترونات للمعالجة والاتصال داخل الرقاقة [المقالة_1: 20][المقالة_1: 21].
من جانب آخر، مركبات III-V: سبائك من عناصر المجموعتين الثالثة والخامسة من الجدول الدوري تُستعمل في بناء ترانزستورات عالية السرعة [المقالة_1: 12].
من جهة ثانية، غرافين والمواد ثنائية الأبعاد الأخرى (2D Materials): تُعتبر واعدة لتوسيع قانون مور [المقالة_1: 10][المقالة_1: 13].
معالج دقيق
- وحدة معالجة الرسوميات (GPU)
- قانون مور
- بنية فون نيومان
- بنية هارفارد
- معالجة متعددة
- معالج متعدد اللب
- تبديد طاقة المعالج
- متحكم دقيق
- تسريع عتادي
- قائمة معالجات إنتل
- قائمة معالجات إي إم دي
- ذاكرة حاسوب
- ذاكرة الوصول العشوائي
- ذاكرة القراءة فقط
- بوابة أو
- بوابة NAND
- المراجع
قياس الأداء وقانون مور
إضافةً إلى ذلك، ومع ذلك، في السنوات الأخيرة، واجه قانون مور تحديات متزايدة بسبب القيود الفيزيائية لتقنية تصنيع السيليكون [المقالة_2: history]. تصبح مشاكل مثل الهجرة الكهربائية (Electromigration) وتيارات التسرب (Leakage Currents) أكثر أهمية مع استمرار تصغير الترانزستورات [المقالة_2: history]. أدى هذا إلى تباطؤ في وتيرة زيادة ترددات الساعة والتركيز بشكل أكبر على تحسينات البنية المعمارية، وزيادة عدد النوى، وتطوير مسرعات متخصصة [المقالة_2: 11].
علاوةً على ذلك، لعدة عقود، كان تطور أداء المعالجات يتبع بشكل وثيق قانون مور (Moore's Law)، وهي ملاحظة أدلى بها غوردون مور في سنة 1965 [المقالة_2: 7] تتوقع أن عدد الترانزستورات في الدوائر المتكاملة (وبالتالي أداء المعالجات) يتضاعف على وجه التقريب كل عامين [المقالة_1: 16][المقالة_1: 17][المقالة_2: 8]. وقد أدى هذا التقدم المذهل إلى زيادة هائلة في قوة الحوسبة، حيث انتقلت الحواسيب الفائقة من حاجز البيتافلوبس (petaFLOPS) (1015 عملية في الثانية) [المقالة_2: 9] (مثل IBM Roadrunner وCray Jaguar في 2008) إلى الإكسافلوبس (exaFLOPS) (1018 عملية في الثانية) (مثل Frontier في 2022) [المقالة_2: 11].
في هذا الإطار، يُعد قياس أداء المعالج أمرًا معقدًا. بينما يُستعمل تردد الساعة (Clock Speed) (يقاس بالميغاهرتز MHz أو الجيغاهرتز GHz) [المقالة_2: b][المقالة_3: 12.2] كمؤشر شائع، إلا أنه لا يعكس الصورة الكاملة، حيث تختلف كفاءة المعالجات في تنفيذ التعليمات لكل دورة ساعة (IPC) بناءً على بنيتها المعمارية. مقاييس أخرى مثل MIPS أو FLOPS (عملية فاصلة عائمة في الثانية) [المقالة_2: speed] قد تكون مفيدة، لكن برامج قياس الأداء (Benchmarks) التي تحاكي أعباء العمل الواقعية تعتبر الطريقة الأكثر موثوقية لمقارنة أداء المعالجات المختلفة [المقالة_2: speed].
تصميم المعالج وتصنيفاته
مجموعات التعليمات (Instruction Sets)
من جهة ثانية، المعالجات الحديثة: غالبًا ما تكون بنية هارفارد المعدلة [المقالة_3: 11]. فهي تظهر للمبرمج كمعمارية فون نيومان (مساحة عنوان موحدة)، ولكنها داخليًا تستعمل نواقل وذاكرة مخبئية منفصلة للتعليمات والبيانات (خاصة في مستوى L1) لتحقيق أداء عالٍ [المقالة_3: 6]. يتم استخدام آليات معقدة لضمان تماسك البيانات بين ذاكرات التخزين المؤقت المختلفة [المقالة_3: 4.5][المقالة_3: 11]. كما يتم استخدام تقنيات حماية الذاكرة لمنع تنفيذ البيانات (مثل NX bit) أو الكتابة فوق كود البرنامج [المقالة_3: 6].
وفي هذا السياق، عرض الكلمة (Word Width / Size): يشير إلى عدد البتات التي يمكن للمعالج معالجتها كوحدة واحدة في سجلاته ووحدة الحساب والمنطق الخاصة به [المقالة_2: numbers][المقالة_3: 12.1]. يؤثر عرض الكلمة على حجم الأعداد التي يمكن معالجتها مباشرة ودقة العمليات الحسابية. كما يؤثر عرض ناقل العناوين على كمية الذاكرة التي يمكن للمعالج الوصول إليها مباشرة (مثلًا، معالج 32-بت) يمكنه عنونة 2^32 بايت = 4 جيجابايت من الذاكرة بشكل مباشر) [المقالة_2: numbers]. عرض ناقل البيانات يحدد كمية البيانات التي يمكن نقلها من وإلى الذاكرة في المرة الواحدة [المقالة_3: 12.1]. تتراوح عرض الكلمات الشائعة في الوقت الحالي من 8-بت في المتحكمات الدقيقة البسيطة إلى 32 بت و 64-بت في أجهزة الكمبيوتر الشخصية والخوادم، وحتى 128 بت في بعض الوحدات المتخصصة (مثل FPU أو وحدات المتجهات) [المقالة_2: numbers].
كذلك، RISC (Reduced Instruction Set Computer): تركز على مجموعة صغيرة ومبسطة من التعليمات، كل منها يؤدي مهمة بسيطة ويمكن تنفيذه بسرعة (غالبًا في دورة ساعة واحدة) [المقالة_2: cisc_risc][المقالة_3: 7]. هذا يبسط تصميم المعالج ويتيح تحسينات مثل خطوط الأنابيب العميقة والترددات العالية. يتطلب الأمر كتابة تعليمات أكثر لتحقيق نفس المهمة المعقدة، مما يزيد العبء على المترجم (Compiler) [المقالة_3: 7]. أمثلة تشمل ARM، MIPS، PowerPC، RISC-V.
من جانب آخر، VLIW (Very Long Instruction Word): تجمع عدة تعليمات بسيطة في "كلمة تعليمات" طويلة جدًا، يتم تحديدها بواسطة المترجم ليتم تنفيذها بالتوازي على وحدات وظيفية مختلفة داخل المعالج [المقالة_2: cisc_risc][المقالة_3: 7]. هذا ينقل جزءًا من تعقيد إدارة التوازي من العتاد إلى البرمجيات (المترجم) [المقالة_3: 7].
من جانب آخر، بنية هارفارد (Harvard Architecture): تستعمل مساحات ذاكرة منفصلة ونواقل منفصلة للتعليمات والبيانات [المقالة_3: 6]. هذا يسمح بجلب التعليمة التالية والوصول إلى البيانات في نفس الوقت، مما يزيد من الأداء المحتمل [المقالة_3: 6]. تاريخياً، كانت مفيدة لفصل كود البرنامج (في ROM) عن البيانات (في RAM) [المقالة_3: 6].
وفي هذا الصدد، بنية فون نيومان (Von Neumann Architecture): تتميز بوجود مساحة ذاكرة واحدة وناقل بيانات واحد لكل من التعليمات والبيانات [المقالة_1: CPU section][المقالة_3: 6]. هذا يبسط التصميم ويسمح بمعاملة الكود كبيانات (مفيد للمترجمات والمصححات)، ولكنه يخلق "عنق زجاجة فون نيومان" لأن التعليمات والبيانات تتنافس على نفس الناقل [المقالة_3: 6].
إضافةً إلى ذلك، التمثيل: تمثل المعالجات الحديثة الأرقام باستخدام النظام الثنائي (Base 2)، حيث يتم تمثيل كل رقم (بت - bit) بحالة فيزيائية مثل جهد كهربائي مرتفع أو منخفض [المقالة_2: numbers].
كذلك، CISC (Complex Instruction Set Computer): تتميز بمجموعة كبيرة من التعليمات، بعضها معقد جدًا ويمكن أن ينفذ عمليات متعددة الخطوات في تعليمة واحدة [المقالة_2: cisc_risc][المقالة_3: 7]. الهدف هو تقريب لغة الآلة من لغات البرمجة عالية المستوى وتقليل عدد التعليمات اللازمة لكتابة برنامج. ومع ذلك، فإن تعقيد هذه التعليمات يجعل تصميم المعالج وتنفيذ تقنيات مثل خط الأنابيب أمرًا صعبًا [المقالة_3: 7]. معمارية x86 هي المثال الأشهر.
من جانب آخر، تجدر الإشارة إلى أن المعالجات الحديثة، حتى تلك التي تتبع معمارية CISC مثل x86، غالبًا ما تترجم داخليًا التعليمات المعقدة إلى سلسلة من العمليات الدقيقة (Micro-operations أو µops) الشبيهة بتعليمات RISC، والتي يتم تنفيذها فيما بعد بواسطة نواة المعالج الشبيهة بـ RISC [المقالة_3: 7].
في هذا الإطار، مجموعة التعليمات (ISA - Instruction Set Architecture) هي مجموعة الأوامر التي يستطيع المعالج فهمها وتنفيذها. هناك فلسفتان رئيسيتان لتصميم مجموعات التعليمات:
وفي هذا السياق، تمثيل الأعداد وعرض الكلمة (Number Representation & Word Width)
المعماريات الأساسية (فون نيومان وهارفارد)
مجالات التطبيق
في هذا الإطار، الحواسيب الشخصية (PCs)، محطات العمل (Workstations)، والخوادم (Servers): حيث تُستعمل معالجات x86 (من إنتل وAMD) بشكل أساسي، على الرغم من تزايد استخدام معالجات ARM في بعض الأجهزة المحمولة والخوادم [المقالة_3: 3].
انظر كذلك
إضافةً إلى ذلك، الحواسيب الفائقة (Supercomputers): تستعمل لحل المشاكل العلمية والهندسية المعقدة، وتعتمد غالبًا على آلاف المعالجات التي تعمل بالتوازي [المقالة_2: 9][المقالة_2: 10][المقالة_2: 11]
ومن جهة أخرى، الأنظمة المدمجة (Embedded Systems): تشكل هذه الفئة الغالبية العظمى (نحو 95%) من سوق المعالجات [المقالة_3: 3]. تشمل الهواتف الذكية، الأجهزة اللوحية، الساعات الذكية، أجهزة التلفزيون، السيارات، الأجهزة المنزلية (الغسالات، الثلاجات)، المعدات الصناعية، الأجهزة الطبية، وغيرها الكثير [المقالة_3: intro].
وفي هذا الصدد، أجهزة الألعاب (Game Consoles): تستعمل معالجات مخصصة غالبًا ما تجمع بين نوى CPU و GPU قوية [المقالة_3: intro].
تُستعمل المعالجات في مجموعة واسعة جدًا من التطبيقات:
معالجة التعليمات والمقاطعات
أنماط العنونة (Addressing Modes)
كذلك، التعليمات (Instructions): هي الأوامر الأساسية التي يفهمها المعالج، وتكون مخزنة في الذاكرة كسلسلة من الأرقام الثنائية (لغة الآلة) [المقالة_2: operations]. لتسهيل البرمجة، تُستعمل لغة تجميع (Assembly) ذات الرموز (Mnemonics) القريبة من لغة الآلة، أو لغة برمجة عالية المستوى (مثل C++، جافا، بايثون) التي يتم ترجمتها (Compile) أو تفسيرها (Interpret) إلى لغة الآلة [المقالة_3: 9.1][المقالة_3: 9.2].
من جانب آخر، العنونة النسبية لعداد البرنامج (PC-Relative): يتم حساب العنوان بجمع إزاحة (Offset) موجودة في التعليمة مع القيمة الحالية لعداد البرنامج (PC). تُستعمل غالبًا في تعليمات القفز والتفرع [المقالة_3: 11.2].
علاوةً على ذلك، تحدد أنماط العنونة كيفية تحديد المعاملات (البيانات) التي تحتاجها التعليمة [المقالة_3: 11]. تشمل الأنماط الشائعة:
إضافةً إلى ذلك، العنونة المباشرة (Direct): التعليمة تحتوي على العنوان المباشر للمعامل في الذاكرة [المقالة_3: 11.2]
وعلى صعيد آخر، العنونة غير المباشرة (Indirect): التعليمة تحتوي على عنوان يشير إلى موقع في الذاكرة، وهذا الموقع بدوره يحتوي على العنوان الفعلي للمعامل (تتطلب وصولًا إضافيًا للذاكرة) [المقالة_3: 11.3].
من جانب آخر، العنونة غير المباشرة بالسجل (Register Indirect): التعليمة تشير إلى سجل يحتوي على عنوان المعامل في الذاكرة [المقالة_3: 11.2].
من جهة ثانية، العنونة المفهرسة (Indexed): يتم حساب عنوان المعامل بجمع محتوى سجل (الفهرس) مع عنوان أساسي (قد يكون في التعليمة أو سجل آخر) [المقالة_3: 11.2].
وفي هذا الصدد، العنونة الفورية (Immediate): المعامل هو جزء من التعليمة نفسها [المقالة_2: decode][المقالة_3: 11.2].
في هذا الإطار، المقاطعات (Interrupts): هي إشارات يمكن أن ترسلها الأجهزة الخارجية (Hardware) أو البرامج (Software) لمقاطعة التنفيذ الحالي للمعالج للتعامل مع حدث عاجل (مثل وصول بيانات من الشبكة أو ضغطة مفتاح). يجب على المعالج حفظ حالته الحالية، تنفيذ روتين خدمة المقاطعة، ثم استعادة حالته ومتابعة البرنامج الأصلي [المقالة_3: 10].
في هذا الإطار، العنونة بالسجل (Register): المعامل موجود في أحد سجلات المعالج. قد يكون السجل محددًا بشكل صريح في التعليمة أو ضمنيًا [المقالة_3: 11.1].
وحدات وتقنيات متقدمة
ومن ناحية أخرى، ايضاً يضم المعالج وحدة إدارة الذاكرة (Memory Management Unit - MMU)، وهى وحدة مسؤولة عن ترجمة العناوين الافتراضية المستعملة بواسطة البرامج إلى عناوين فعلية في الذاكرة الرئيسية، وتوفير حماية الذاكرة، وإدارة تماسك الذاكرة المخبئية (Cache Coherence). وأيضاً وحدة النقطة العائمة (Floating-Point Unit - FPU)، وهى وحدة متخصصة لتسريع العمليات الحسابية على الأعداد الحقيقية (ذات الفاصلة العائمة). يضم كذلك خط الأنابيب (Pipeline)، وهى تقنية تقسم عملية تنفيذ التعليمة إلى مراحل متعددة، مما يسمح بمعالجة أجزاء من تعليمات مختلفة بشكل متزامن، مثل خط التجميع.
ومن ناحية أخرى، تحتوي المعالجات الحديثة غالبًا على وحدات إضافية لتعزيز الأداء والوظائف، مثل الذاكرة المخبئية (Cache Memory)، وهى ذاكرة صغيرة وسريعة جدًا مدمجة في المعالج أو قريبة جدًا منه، وتستعمل لتخزين نسخ من البيانات والتعليمات المستعملة بشكل متكرر من الذاكرة الرئيسية الأبطأ. هذا يقلل من وقت الوصول للبيانات ويحسن الأداء. توجد عادةً عدة مستويات من الذاكرة المخبئية، بالترتيب L1 وهو الأصغر والأسرع والأقرب إلى نواة المعالج إلى L3 وأحيانًا L4.
علاوةً على ذلك، يمكن للمعالج كذلك محاولة توقع مسار تنفيذ البرنامج عند نقاط التفرع الشرطي باستخدام وحدة التنبؤ بالتفرع (Branch Prediction Unit)، وذلك لتقليل توقف خط الأنابيب، هناك وحدات أخرى مهمة، مثل وحدة معالجة المتجهات Vector Units والتي منها تكنولوجيات تدفق سيمد الملحقة SSE أو ألتي فيك AltiVec، وأيضاً وحدات لمعالجة الإشارات الرقمية (DSP)، أو وحدات تسريع التشفير.
أنواع المعالجات
علاوةً على ذلك، مصفوفة البوابات المنطقية القابلة للبرمجة (FPGA - Field-Programmable Gate Array): دوائر متكاملة يمكن إعادة تكوينها بواسطة المستعمل بعد التصنيع لتنفيذ وظائف منطقية مخصصة، وتُستعمل أحيانًا كمسارعات [المقالة_1: types_fpga].
وعلى صعيد آخر، معالجات الكم (Quantum Processors): تستعمل مبادئ ميكانيكا الكم (مثل التراكب والتشابك) لتمثيل ومعالجة المعلومات في شكل كيوبتات (qubits). لديها القدرة على حل أنواع معينة من المشاكل التي يستحيل على أجهزة الكمبيوتر الكلاسيكية حلها بكفاءة [المقالة_1: 14][المقالة_1: 15].
وفي هذا السياق، متحكم دقيق (Microcontroller): معالج بسيط غالبًا ما يكون مدمجًا مع ذاكرة ومنافذ إدخال/إخراج ومكونات أخرى على نفس الرقاقة، مصمم للتحكم في الأنظمة المدمجة (مثل الأجهزة المنزلية والسيارات) [المقالة_3: intro]. تشكل المتحكمات الدقيقة الغالبية العظمى من سوق المعالجات [المقالة_3: 3].
وفي هذا السياق، المعالجات الضوئية (Photonic Processors): تستعمل الضوء (الفوتونات) بدلاً من الإلكترونات لإجراء العمليات الحسابية، مما قد يوفر سرعات أعلى واستهلاك طاقة أقل [المقالة_1: 20][المقالة_1: 21].
من جهة ثانية، وحدة معالجة الرسوميات (GPU - Graphics Processing Unit): مصممة في الأصل لتسريع عمليات عرض الرسومات ثلاثية الأبعاد والألعاب، ولكنها تُستعمل الآن كذلك على نطاق واسع في حوسبة عالية الأداء، حوسبة علمية وتعلم الآلة نظرًا لبنيتها المتوازية للغاية [المقالة_1: 8][المقالة_1: 18].
وفي هذا الصدد، معالج إشارة الصورة (ISP - Image Signal Processor): نوع متخصص من DSP لمعالجة الصور، يوجد غالبًا في الكاميرات الرقمية والهواتف الذكية [المقالة_1: types_dsp].
ومن جهة أخرى، فضلًا عن وحدة المعالجة المركزية (CPU) التقليدية المصممة للمهام العامة [المقالة_1: types_cpu]، توجد أنواع أخرى من المعالجات المتخصصة في مهام معينة:
وفي السياق ذاته، معالج إشارات رقمية (DSP - Digital Signal Processor): مُحسَّن لمعالجة الإشارات الرقمية في الوقت الفعلي، مثل الصوت والفيديو والاتصالات اللاسلكية [المقالة_1: types_dsp][المقالة_2: 14].
من جهة ثانية، وحدة معالجة الفيزياء (PPU - Physics Processing Unit): مصممة لتسريع حسابات الفيزياء في الألعاب والمحاكاة [المقالة_1: 19].
من جهة ثانية، وحدة معالجة اللغة (LPU - Language Processing Unit): نوع جديد نسبيًا يركز على تسريع نماذج اللغة الكبيرة (LLMs) [المقالة_2: 16][المقالة_2: 17][المقالة_2: 18].
وعلى صعيد آخر، مُسرعات الذكاء الاصطناعي (AI Accelerators) / وحدة المعالجة العصبونية (NPU - Neural Processing Unit): مصممة خصيصًا لتسريع عمليات التعلم الآلي والشبكات العصبية العميقة. تشمل أمثلة مثل وحدة معالجة الموتر (TPU - Tensor Processing Unit) من جوجل [المقالة_1: types_ai][المقالة_2: 15] ووحدة معالجة الرؤية (VPU - Vision Processing Unit) [المقالة_1: types_ai].
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟