ويسبر (نظام التعرف على الكلام)
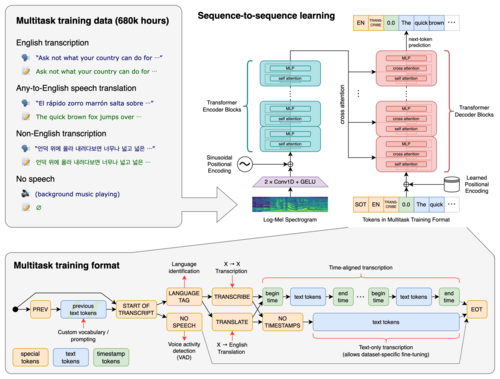
قبل الخوض في التفاصيل، ويسبر هو نموذج تعلم آلي للتعرف على الكلام والنسخ الصوتي، أنشأته شركة OpenAI وأُصدر لأول مرة كبرمجية مفتوحة المصدر في سبتمبر 2022. ونتناول فيما يلي مزيدًا من التفاصيل.
ومن جهة أخرى، يتمتع النموذج بالقدرة على نسخ الكلام باللغة الإنجليزية وعدة لغات أخرى، كما يمكنه ترجمة الكثير من اللغات غير الإنجليزية إلى الإنجليزية.
علاوةً على ذلك، يُعد ويسبر نموذجاً صوتياً للتعلم العميق بنظام الإشراف الضعيف، وتم بناؤه باستخدام بنية محول الترميز وفك التشفير.
في هذا الإطار، وتدعي OpenAI أن الجمع بين بيانات التدريب المختلفة المستعملة في تطويره أدى إلى تحسين التعرف على اللهجات، وضوضاء الخلفية، والمصطلحات التقنية مقارنة بالنهج السابقة.
وفي السياق ذاته، أُصدرت النسخة (Whisper Large V2) في 8 ديسمبر 2022. ثم أُصدرت النسخة (Whisper Large V3) في نوفمبر 2023 خلال يوم مطوري OpenAI. وفي مارس 2025، أطلقت OpenAI نماذج نسخ جديدة تعتمد على المحول المولد مسبق التدريب 4 أومني وGPT-4o mini، وكلاهما يتميز بمعدلات خطأ أقل من ويسبر.
القدرة
إضافةً إلى ذلك، وجدت تقييمات طرف ثالث مستويات متفاوتة من هلوسة الذكاء الاصطناعي. حيث وجدت دراسة لنسخ الاجتماعات العامة هلوسات في ثمانية من كل 10 نصوص، بينما اكتشف مهندس هلوسات في "نحو نصف" 100 ساعة من النسخ، وحدد مطور وجودها في "كل نص على وجه التقريب" من بين 26,000 نص. كما وجدت دراسة لـ 13,140 مقطعاً صوتياً قصيراً (متوسطها 10 ثوانٍ) 187 هلوسة (1.4%)، أنتجت 38% منها نصوصاً قد تكون ضارة لأنها أدرجت إشارات خاطئة لأشياء مثل العرق، أو أدوية غير موجودة، أو أحداث عنيفة لم تكن موجودة في الصوت الأصلي.
وفي هذا الصدد، لا يتفوق ويسبر على النماذج المتخصصة في مجموعة بيانات "LibriSpeech"، ومع ذلك، عند اختباره عبر الكثير من مجموعات البيانات، فإنه يظهر متانة أكبر ويحقق أخطاء أقل بنسبة 50% من النماذج الأخرى. يمتلك ويسبر معدل خطأ متفاوت فيما يتعلق بنسخ اللغات المختلفة، مع معدل خطأ في الكلمات أعلى في اللغات غير الممثلة بشكل جيد في بيانات التدريب. وجد المؤلفون أن التعلم متعدد المهام حسن الأداء العام مقارنة بالنماذج المتخصصة في مهمة واحدة. وتوقعوا أن أفضل نموذج ويسبر تم تدريبه لا يزال يعاني من نقص الملاءمة لمجموعة البيانات، وأن النماذج الأكبر والتدريب الأطول قد يؤديان إلى نماذج أفضل.
التطبيقات
- انظر كذلك
- طفرة الذكاء الاصطناعي
- ترجمة آلية عصبية
ومن جهة أخرى، تم استخدام النموذج كقاعدة للعديد من التطبيقات، مثل نموذج موحد للتعرف على الكلام والتعرف على الأصوات بشكل عام.
التصفية بعد التدريب
في هذا الإطار، بعد تدريب النموذج الأول، قام الباحثون بتشغيله على مجموعات فرعية مختلفة من بيانات التدريب، يمثل كل منها مصدراً متميزاً. صُنفت مصادر البيانات من خلال مزيج من معدل الخطأ والحجم. وساعد الفحص اليدوي للمصادر ذات التصنيف الأعلى (خطأ عالٍ، حجم كبير) في تحديد ما إذا كان المصدر منخفض الجودة (مثل النسخ الجزئي، أو المحاذاة غير الدقيقة). فيما بعد تمت إزالة المصادر منخفضة الجودة.
الخلفية
وفي السياق ذاته، بحسب تقرير صادر عن صحيفة نيويورك تايمز، اعتقدت OpenAI في سنة 2021 أنها استنفدت مصادر البيانات عالية الجودة لتدريب نماذجها اللغوية الكبيرة، وقررت استكمال النصوص المجمعة من الويب بنسخ مكتوبة لفيديوهات يوتيوب والبودكاست، وطورت "ويسبر" لحل هذه المهمة.
وعلى صعيد آخر، أزاحت "المحولات" (Transformers)، التي قدمتها شركة جوجل في سنة 2017، الكثير من الأساليب السابقة المتطورة في الكثير من مشكلات تعلم الآلة، وبدأت تصبح البنية العصبية الأساسية في مجالات مثل نمذجة اللغة والرؤية الحاسوبية. وفي أوائل العشرينيات من القرن الحالي، تم الاعتراف بمناهج الإشراف الضعيف لتدريب النماذج الصوتية كتقنية واعدة لأساليب التعرف على الكلام باستخدام الشبكات العصبية العميقة.
من جهة ثانية، يمتلك التعرف على الكلام تاريخاً طويلاً في البحث العلمي؛ حيث استعملت الأساليب الأولى طرقاً إحصائية، مثل تزيح الوقت الديناميكي، ولاحقاً نماذج ماركوف المخفية. وفي نحو عام 2010، أصبحت مناهج الشبكات العصبية العميقة أكثر شيوعاً في نماذج التعرف على الكلام، وهو ما مكنه توفر مجموعات البيانات الضخمة وزيادة الأداء الحسابي. تضمنت الأساليب المبكرة للتعلم العميق في التعرف على الكلام الشبكات العصبية التفافية، والتي كانت محدودة بسبب عدم قدرتها على التقاط البيانات المتسلسلة، مما أدى لاحقاً إلى تطوير مناهج تسلسل إلى تسلسل (Seq2seq)، والتي تشمل الشبكات العصبية المتكررة التي استعملت تقنية الذاكرة الطويلة قصيرة المدى.
البيانات
من جانب آخر، شملت المعالجة المسبقة توحيد النصوص، والتصفية لإزالة النصوص المولدة آلياً باستخدام أساليب استدلالية (مثل علامات الترقيم، وحالة الأحرف)، وتحديد اللغة ومطابقتها مع النصوص، وإزالة التكرار التقريبي، وإزالة التكرار مع مجموعات بيانات التقييم لتجنب تلوث البيانات. كما تم تضمين المقاطع الخالية من الكلام للسماح بالتدريب على اكتشاف النشاط الصوتي. بالنسبة للملفات المتبقية بعد عملية التصفية، تم تقسيم الملفات الصوتية إلى مقاطع مدتها 30 ثانية مقترنة بجزء النص الذي يظهر خلال ذلك الوقت.
من جانب آخر، إذا كانت اللغة المنطوقة المتوقعة تختلف عن لغة النص المرتبط بالصوت، فلن يتم استخدام زوج (الصوت-النص) هذا لتدريب نماذج التعرف على الكلام، بل لتدريب الترجمة بدلاً من ذلك.
ومن ناحية أخرى، تتكون مجموعة بيانات التدريب من 680,000 ساعة من أزواج (صوت-نص) مصنفة ومستقاة من الإنترنت. يتضمن ذلك 117,000 ساعة بـ 96 لغة غير إنجليزية و125,000 ساعة من بيانات الترجمة من اللغات الأخرى إلى الإنجليزية.
التدريب
في هذا الإطار، تم تدريب ويسبر باستخدام التعلم شبه الموجه على 680,000 ساعة من البيانات متعددة اللغات والمهام، منها نحو الخمس (117,000 ساعة) كانت بيانات صوتية غير إنجليزية. بعد التدريب، تم ضبطه بدقة لمنع التنبؤ بأسماء المتحدثين.
ومن جهة أخرى، تم التدريب باستخدام المحسن "AdamW" مع قص معيار التدرج واضمحلال خطي لمعدل التعلم مع فترة إحماء، وبحجم دفعة قدره 256 مقطعاً. استمر التدريب لمليون تحديث (2-3 حقبات/epochs). لم تُستعمل أي تقنيات لزيادة البيانات أو التسوية، باستثناء نموذج (Large V2) الذي استعمل "SpecAugment" و "Stochastic Depth" و "BPE Dropout". استعمل التدريب توازي البيانات مع تنسيق float16، وتوسيع نطاق الخسارة الديناميكي، ونقاط تفتيش التنشيط.
البنية
وفي السياق ذاته، تتم إعادة عينة الصوت المدخل إلى 16,000 هرتز وتحويله إلى مخطط طيف ميل ذو 80 قناة باستخدام نوافذ زمنية مدتها 25 مللي ثانية مع خطوة قدرها 10 مللي ثانية. يتم لاحقًا تسوية مخطط الطيف إلى نطاق [-1، 1] بمتوسط يقترب من الصفر.
<|nospeech|> للكشف عن النشاط الصوتي.
- تُستعمل رموز خاصة (tokens) للسماح لوحدة فك التشفير بأداء مهام متعددة:
- رموز تشير إلى اللغة (رمز فريد لكل لغة).
- رموز تحدد المهمة (<|transcribe|> للنسخ أو <|translate|> للترجمة).
إضافةً إلى ذلك، <|startoftranscript|> و <|endoftranscript|>. أي نص يظهر قبل <|startoftranscript|> لا يتم توليده بواسطة وحدة فك التشفير، بل يُعطى لها كسياق. يتم حساب الخسارة (Loss) فقط على الأجزاء غير السياقية من التسلسل، أي الرموز الموجودة بين هذين الرمزين الخاصين.
من جانب آخر، أما وحدة فك التشفير (Decoder) فهي عبارة عن مفكك تشفير محول قياسي. لها نفس العرض وكتل المحول الموجودة في المشفر. تستعمل تضمينات موضعية متعلمة وتمثيلات رموز مدخلات ومخرجات مرتبطة (باستخدام نفس مصفوفة الوزن لكل من تضمينات المدخلات والمخرجات). كما تستعمل أداة ترميز ترميز زوج البايت (byte-pair encoding)، من نفس النوع المستعمل في GPT-2. تستعمل النماذج المخصصة للغة الإنجليزية فقط مفردات GPT-2، بينما تستعمل النماذج متعددة اللغات مفردات متعددة اللغات أعيد تدريبها بنفس عدد الكلمات.
تعتمد بنية ويسبر على محول ترميز وفك تشفير.
ومن جهة أخرى، رموز تحدد ما إذا كانت الطوابع الزمنية غائبة (<|notimestamps|>). إذا لم يكن الرمز موجوداً، فإن وحدة فك التشفير تتوقع طوابع زمنية بالنسبة للمقطع، ومكممة إلى فترات 20 مللي ثانية.
علاوةً على ذلك، يأخذ المشفر (Encoder) مخطط طيف ميل هذا كمدخل ويعالجه. يمر أولاً عبر طبقتين إلتفافيتين. ثم تُضاف تضمينات موضعية جيبية. فيما بعد، تتم معالجته بواسطة سلسلة من كتل مشفر المحول (مع وصلات متبقية قبل التنشيط). يتم تسوية مخرجات المشفر عبر الطبقات.
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟